DeepInfer Field Notes 独立 / 粉丝制作
图 01 — 发布档案 / 2026.10

DeepInfer:DeepSeek 的 V4.1-Flash 推理框架

DeepInfer 是 DeepSeek 开源的推理框架,用于大规模服务 DeepSeek-V4.1-Flash。这份独立技术笔记覆盖 Apache-2.0 发布内容、NVIDIA SM100 与 Huawei Ascend 950 两条硬件路径、基准测试的限定条件,以及本次发布未包含的 KV cache、prefill/decode 与负载均衡部分。

发布时间2026 年 10 月 20 日UTC
代码许可证Apache-2.0权重:MIT
模型V4.1-Flash仅此一个
硬件SM100 / Ascend 950仅限 Linux
定位离线引擎不是托管 API
快照 2026-10-20 11:30 UTC/ 基于公开来源/ 未做实测/ 独立制作,非官方
一句话版本

一个引擎、一条边界,还有一组需要加注脚的数字。

阅读时间:6 分钟

它是什么

一个从生产环境衍生出来的推理引擎:优化算子、专家并行、投机解码、滑动窗口缓存恢复、异步调度,以及确定性模式。DeepSeek 同时发布了 deepseek-recipe,一个用于 API 协议转换和分词处理的配套库。

它不是什么

  • 不是模型。模型是 V4.1-Flash。
  • 不是托管 API,也不是 OpenAI 兼容服务器。
  • 不是完整的服务栈:KV cache、PD 分离和负载均衡都不在其中。
  • 不是能跑其它模型的通用引擎。

为什么值得关注

它难得地展示了 DeepSeek 究竟如何服务一个前沿开放权重模型:decode 阶段的 Wide-EP、按置信度调度的投机验证,以及用可控重算换取近似的缓存策略。即使你从不运行这份代码,这些思路也依然有用。

一句话说清边界。DeepInfer 是离线推理引擎,不是托管 API,也不是模型;本次发布不包含完整在线服务所需的 KV cache 系统、prefill/decode 分离和数据并行负载均衡。
范围

实际交付了什么

官方 README + Q&A
01 / 算子

拼装完成的算子栈

FlashMLA、DeepGEMM、DeepEP、TileKernels、DeepSelect 以及自研 TileLang 算子被接入同一个引擎。这些组件此前已陆续开源,这次发布把它们串成了一个引擎。

02 / 并行

Wide-EP 与 EPLB

注意力部分采用数据并行,MoE 部分采用专家并行。在 DeepSeek 的生产设计中,decode 会把专家分散到 64–128 块 GPU 上,并用冗余副本重新平衡热点专家。

03 / 投机

DSpark:变长验证

系统预先提出 draft token,再由置信度头预测哪些值得验证。DeepSeek 称在其生产工作点上吞吐提升 4–7%。

04 / 缓存

SWA 有界重放

引擎不逐层重建完整的滑动窗口缓存,只重放最近的一段尾部 token。结果是近似的,但重算成本被限定在常数范围内。

05 / 调度

默认异步

GPU 执行当前批次时,CPU 已经在准备下一批。目标是消除 decode 步与步之间的空闲间隙——一个真正能换来吞吐的工程细节。

06 / 可复现性

确定性模式

批次不变推理与确定性采样在 NVIDIA 平台上可用。这类特性并不起眼,却让基准测试和 agent 运行变得可审计。
已包含

  • DeepSeek-V4.1-Flash 的离线推理
  • 优化算子与模型/采样器运行时
  • 注意力 DP、均衡 CP、MoE EP + EPLB
  • DSpark、SWA 有界重放、异步调度
  • 批次不变与确定性模式(NVIDIA)
  • 结构化输出:regex、JSON Schema、EBNF
  • deepseek-recipe(独立的 MIT 仓库)

未包含

  • KV cache 系统
  • VE / Prefill / Decode 分离
  • 跨数据并行副本的负载均衡
  • 面向用户的在线 API
  • 对其它 DeepSeek 模型的支持
  • Ascend 950 的公开性能数据
  • 第三方对图表的复现
数字

基准数字,以及它们的注脚

官方图表 / 131,072 上下文
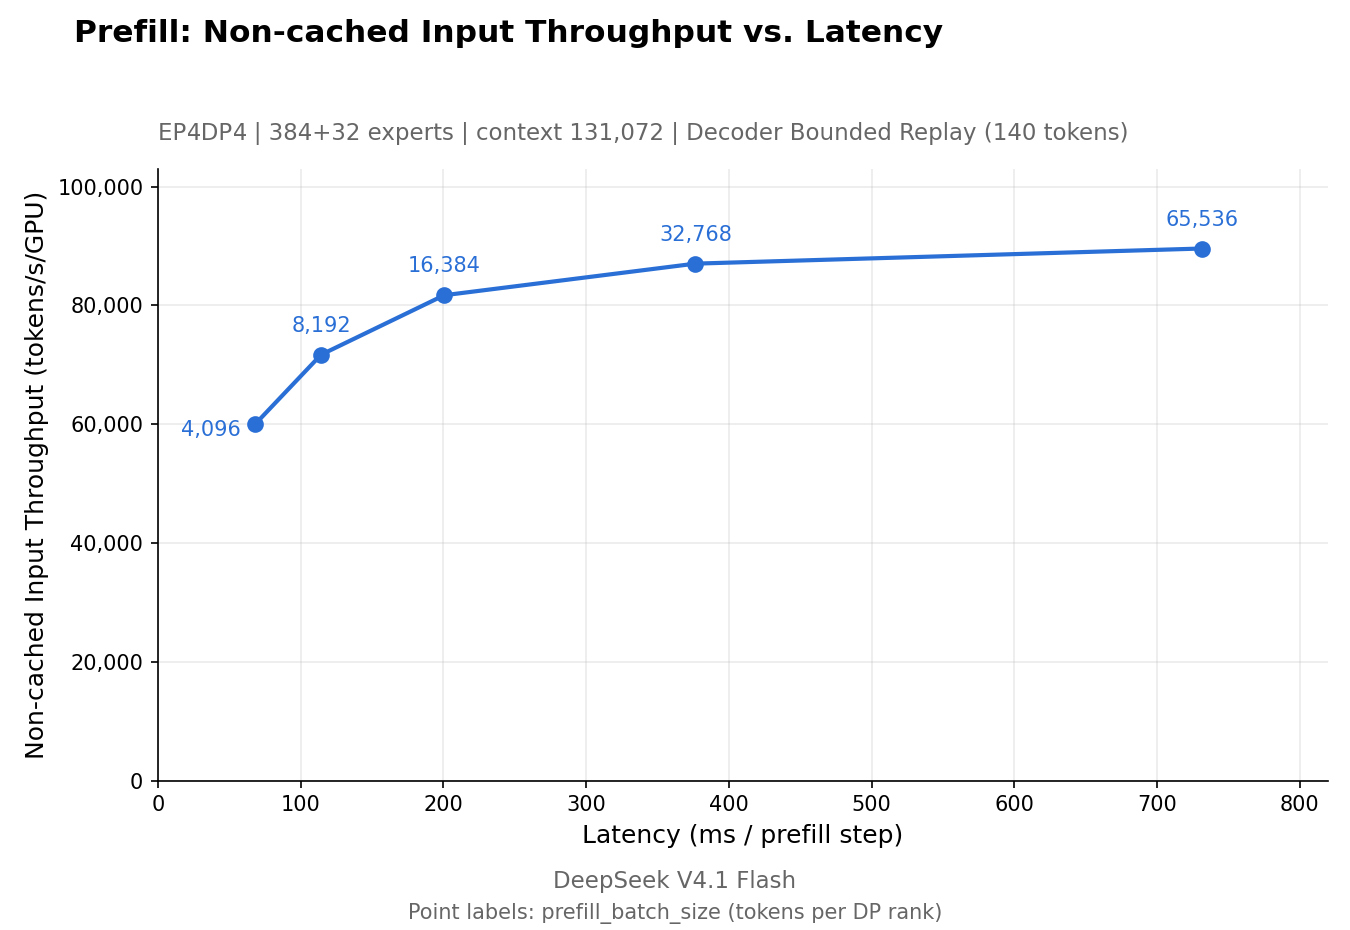
DeepInfer prefill Pareto 图:四块 SM100 GPU 上非缓存输入吞吐与延迟的关系
Prefill。4×SM100、EP4DP4、384+32 专家、131,072 token 上下文。图中的标签是批量大小,不是吞吐数值。来源:DeepInfer README(Apache-2.0)。
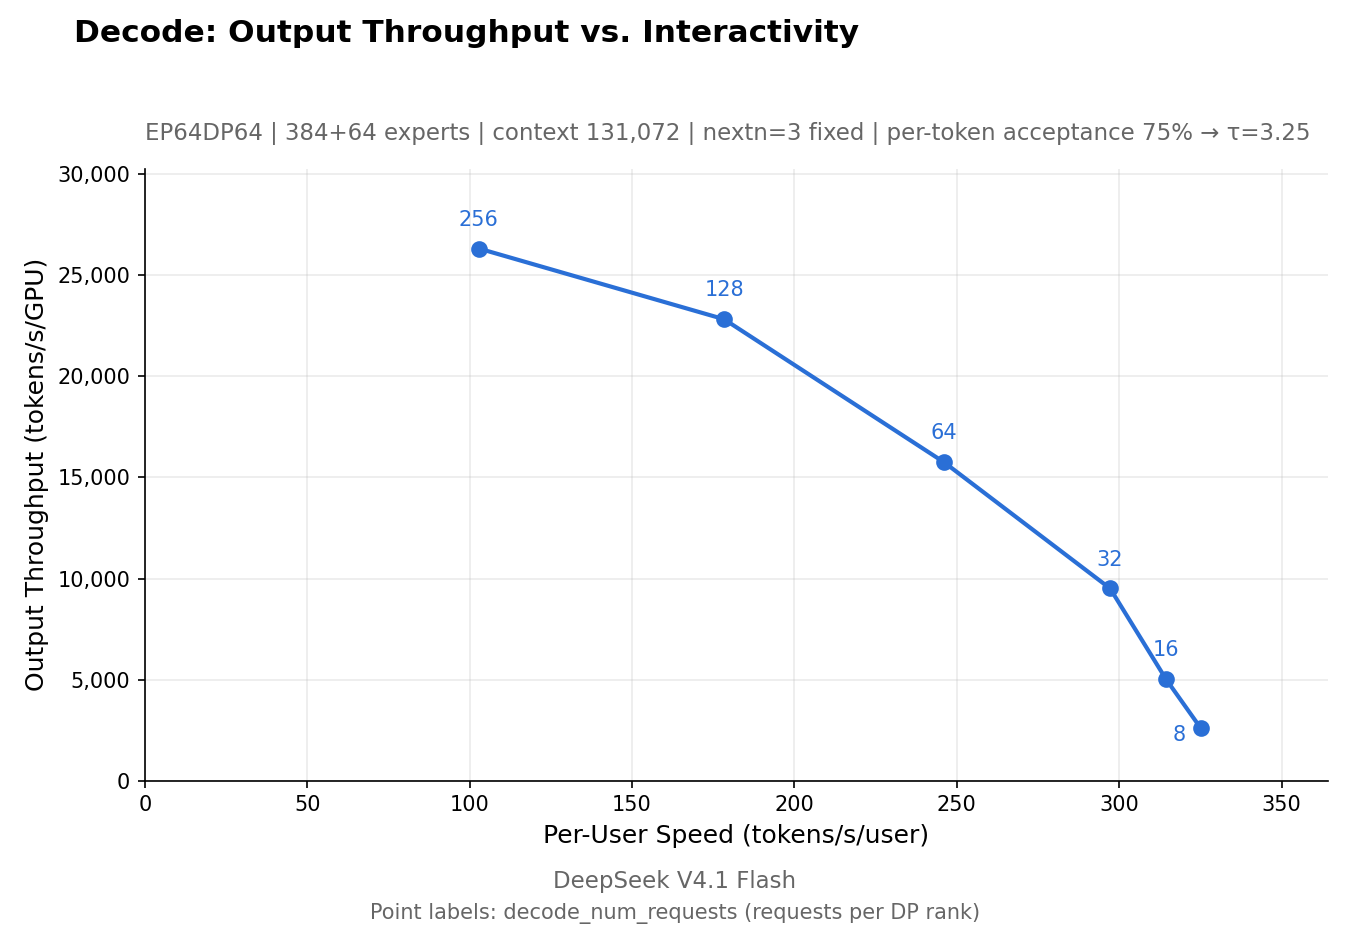
DeepInfer decode Pareto 图:64 块 SM100 GPU 上输出吞吐与单用户速度的关系
Decode。64×SM100、EP64DP64、384+64 专家、131,072 token 上下文,nextn=3 固定,draft 接受率 75%。来源:DeepInfer README(Apache-2.0)。
131,072 两张图共同使用的上下文长度 不是模型 1M token 的上限。
4 + 64 prefill + decode 使用的 SM100 GPU 数量 各自位于一个 scale-up 域内。
0 我们能找到的第三方复现 截至 2026-10-20 11:30 UTC。
看坐标轴,别看标题。prefill 图是吞吐对单步延迟,decode 图是吞吐对单用户速度。两者都没有承诺端到端请求延迟、单 token 成本,也没有承诺你的负载会得到同样结果。decode 图还假设 draft 接受率为 75%;文本越难预测,收益越低。
缺口

大多数发布稿略过的那部分

三块缺失的拼图

DeepInfer 是引擎,不是服务。README 对这两者的差别说得异常直白:一个完整的推理服务还需要 KV cache 系统、prefill/decode 分离,以及跨数据并行副本的负载均衡。这三样都不在发布内容里。

这个缺口算不上丑闻,而是一条设计边界:DeepSeek 留下了与自己内部基础设施耦合最紧的部分。但它确实改变了谁能用这份代码,以及能对它抱什么期待。

你需要自己补的部分

  • 能跨请求、跨机器存活的 prefix/KV cache
  • 独立的 prefill 与 decode 资源池,以及传输和路由
  • 同时感知请求数量和缓存长度的负载均衡
  • API 服务器、鉴权、配额、计费和可观测性
名称核查

你读的是哪个 DeepInfer?

一个名字,几个项目
DeepSeek2026 · LLM 推理 · 本站
医学影像2016 · 3D Slicer · 无关
智能合约2023 · 字节码类型推断 · 无关
DeepInfra拼写不同 · 公司不同

DeepInfer 这个名字还指一个 2016 年的医学影像工具包,以及一个 2023 年的智能合约类型推断研究项目;本站只讨论 DeepSeek 在 2026 年发布的推理框架。完整名称辨析 →

发布日志

事情是怎么走到这一步的

时间为 UTC
  1. 2025-04

    DeepSeek 表示完整开源推理引擎并不现实:代码已与 vLLM 分叉,且与内部基础设施深度耦合,团队也没有足够的维护人力。

  2. 2026-09-30

    Ascend 侧铺路:DeepGEMM-Ascend、DeepEP-Ascend,以及算子栈的 Ascend 后端。此时还没有 DeepInfer。

  3. 2026-10-16

    仓库 deepseek-ai/DeepInfer 创建。

  4. 2026-10-20 09:30

    官方 X 推文串与公开仓库上线。代码以三个公开 commit 落地。

  5. 2026-10-20 11:26

    快照:约 5.4k stars、408 forks、47 个未关闭条目。Hacker News 上已有 120 条评论的讨论串。

社区信号

反复出现的技术质疑不在于速度,而在于缺失的 KV cache。几个小时内,贡献者还提交了 SM90/H20 和 Ascend 910C 支持的 RFC——这是官方硬件清单之外的需求,不是已交付的支持。

我们没有做的事

我们没有运行 DeepInfer。我们也没有 SM100 或 Ascend 950 硬件。本站每个数字都注明了公开来源,每条无法核实的说法都做了标记。

对比

DeepInfer 与 10 个服务框架

VS / VLLM

DeepInfer vs vLLM

只服务一个模型的 DeepSeek 引擎,对上带 API 层、支持 200+ 模型的通用服务框架。

阅读对比 →
VS / SGLANG

DeepInfer vs SGLang

最接近 V4.1-Flash 的一组对比:DSpark、PD 分离、HiCache,以及 preview 构建的注意事项。

阅读对比 →
VS / TENSORRT-LLM

DeepInfer vs TensorRT-LLM

DeepSeek 的 V4.1 引擎对上 NVIDIA 的通用服务栈。决定胜负的是硬件锁定和 API 覆盖范围。

阅读对比 →
接着读

继续深入

六篇
↑