하나로 묶인 커널 스택
FlashMLA, DeepGEMM, DeepEP, TileKernels, DeepSelect, 그리고 자체 제작한 TileLang 커널이 하나의 엔진으로 연결됩니다. 조각들은 이전에도 공개된 적이 있지만, 이번 릴리스에서 하나의 엔진으로 묶였습니다.
DeepInfer는 DeepSeek-V4.1-Flash를 대규모로 서빙하기 위한 DeepSeek의 오픈소스 추론 프레임워크입니다. 이 독립 필드 가이드는 Apache-2.0 릴리스, NVIDIA SM100과 Huawei Ascend 950 하드웨어 경로, 벤치마크의 유의점, 그리고 이번 릴리스에 포함되지 않은 KV cache·프리필/디코드·로드 밸런싱 요소를 다룹니다.
프로덕션에서 출발한 추론 엔진입니다. 최적화된 커널, 전문가 병렬화, 추측 디코딩, 슬라이딩 윈도 캐시 복구, 비동기 스케줄링, 결정론적 모드를 갖췄습니다. DeepSeek는 API 프로토콜 변환과 토큰화를 담당하는 동반 라이브러리 deepseek-recipe도 함께 공개했습니다.
DeepSeek가 프런티어 오픈 가중치 모델을 실제로 어떻게 서빙하는지 들여다볼 수 있는 드문 사례입니다. 디코드 단계의 Wide-EP, 신뢰도를 기준으로 스케줄링되는 추측 디코딩, 정확성을 내주는 대신 재계산 비용에 상한을 두는 캐시 정책이 담겨 있습니다. 코드를 직접 실행하지 않더라도 아이디어 자체는 쓸모가 있습니다.
FlashMLA, DeepGEMM, DeepEP, TileKernels, DeepSelect, 그리고 자체 제작한 TileLang 커널이 하나의 엔진으로 연결됩니다. 조각들은 이전에도 공개된 적이 있지만, 이번 릴리스에서 하나의 엔진으로 묶였습니다.
어텐션은 데이터 병렬화를, MoE 부분은 전문가 병렬화를 사용합니다. DeepSeek의 프로덕션 설계에서 디코드 단계는 전문가를 64–128개 GPU에 분산하고, 붐비는 전문가는 중복 복사본으로 다시 분배합니다.
드래프트 토큰을 미리 제안하고, 신뢰도 헤드가 어떤 토큰을 검증할 가치가 있는지 예측합니다. DeepSeek는 프로덕션 운용 지점에서 처리량이 +4–7% 늘어난다고 밝힙니다.
모든 레이어에 걸쳐 슬라이딩 윈도 캐시를 전부 다시 만드는 대신, 최근 꼬리 구간만 재생합니다. 결과는 근사치이지만 재계산 비용에는 상한이 생깁니다.
GPU가 현재 배치를 처리하는 동안 CPU가 다음 배치를 준비합니다. 목표는 디코드 스텝 사이의 유휴 구간을 없애는 것이며, 이는 처리량에 실제로 영향을 주는 엔지니어링 디테일입니다.
배치 불변 추론과 결정론적 샘플링은 NVIDIA에서 사용할 수 있습니다. 화려하지는 않지만 벤치마크와 에이전트 실행을 감사 가능하게 만드는 기능입니다.
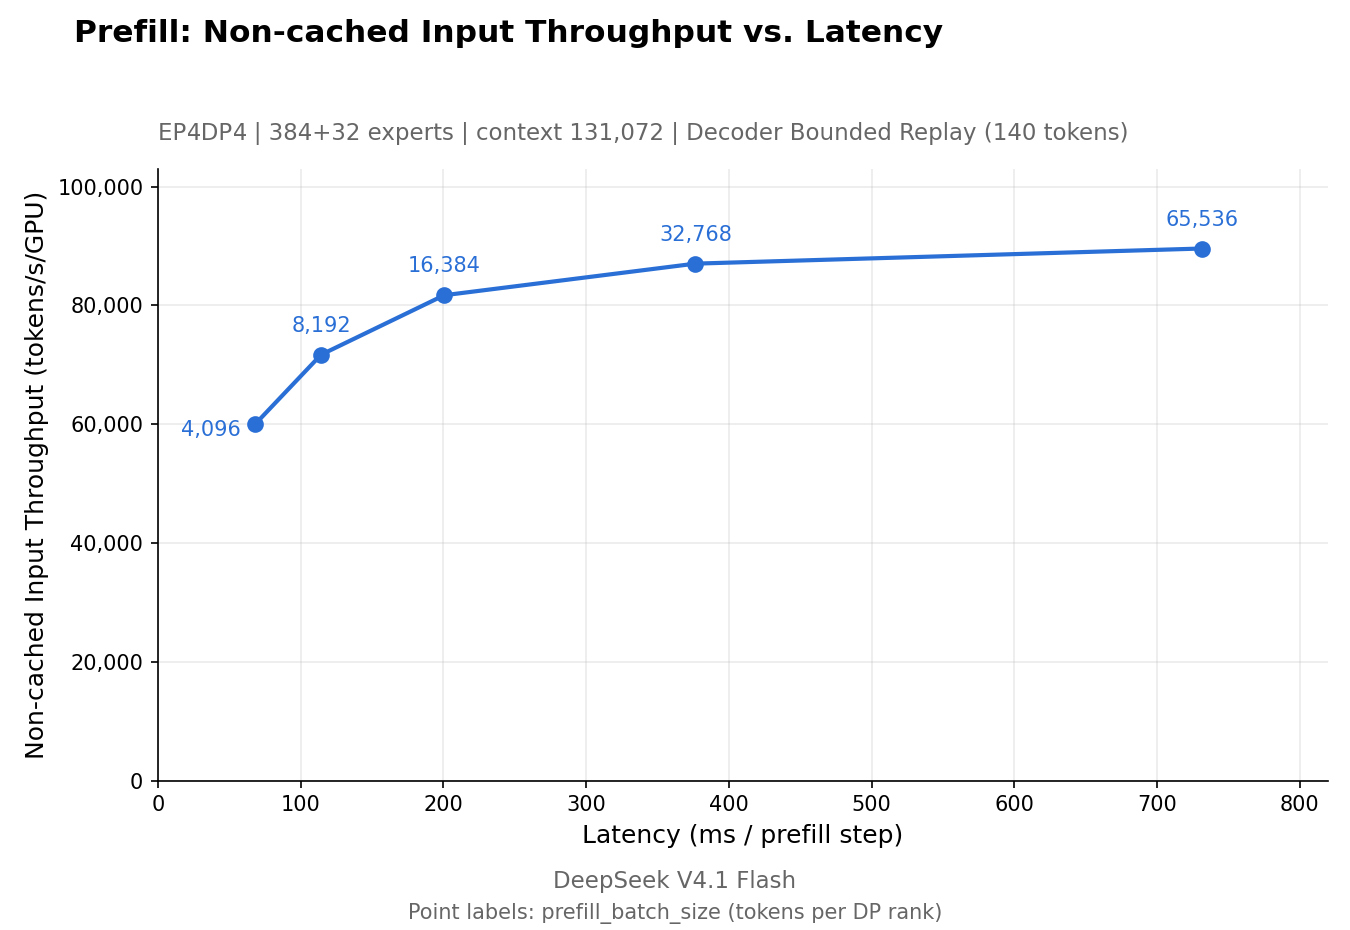
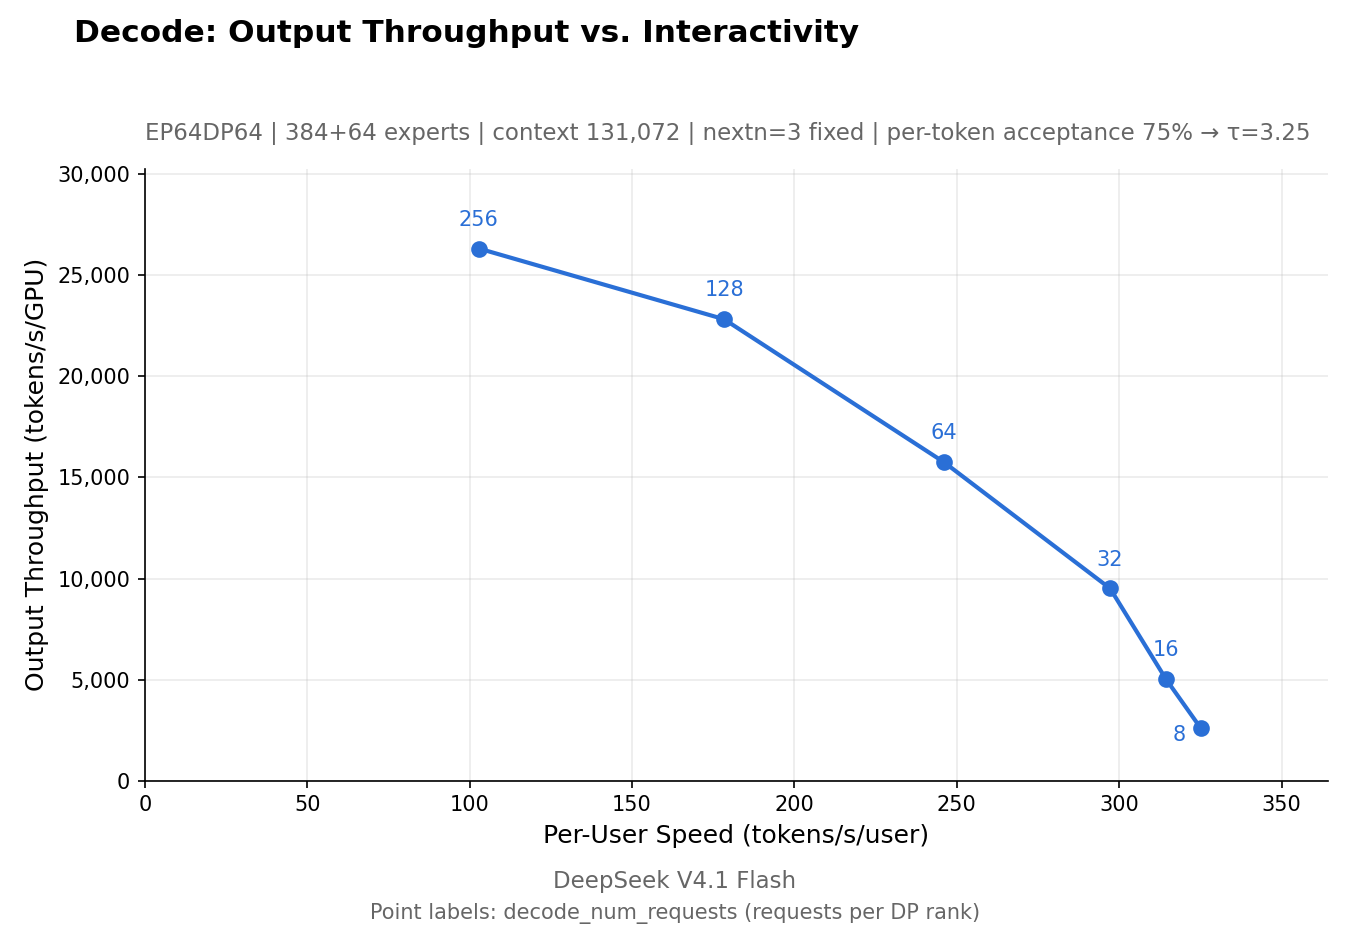
DeepInfer는 서비스가 아니라 엔진입니다. README는 이 차이를 이례적으로 분명하게 밝힙니다. 완전한 추론 서비스에는 KV cache 시스템, 프리필/디코드 분리, 데이터 병렬 복제본 간 로드 밸런싱이 추가로 필요합니다. 세 가지 모두 이번 릴리스에는 없습니다.
이 빈틈이 스캔들은 아닙니다. 설계상의 경계입니다. DeepSeek는 내부 인프라와 가장 강하게 결합된 부분을 남겨 두었습니다. 다만 이 경계는 누가 이 코드를 쓸 수 있는지, 무엇을 기대할 수 있는지를 바꿉니다.
DeepInfer라는 이름은 2016년 의료 영상 툴킷과 2023년 스마트 컨트랙트 타입 추론 프로젝트도 가리킵니다. 이 사이트는 DeepSeek의 2026년 추론 프레임워크만 다룹니다. 이름 구분 전체 보기 →
DeepSeek는 추론 엔진 전체를 공개하는 것은 현실적이지 않다고 밝힙니다. 코드가 vLLM에서 크게 갈라졌고 내부 인프라와 결합되어 있으며, 팀에 유지보수 여력이 없다는 이유였습니다.
Ascend 기반 작업: DeepGEMM-Ascend, DeepEP-Ascend, 커널 스택용 Ascend 백엔드가 나옵니다. 아직 DeepInfer는 없습니다.
이때 deepseek-ai/DeepInfer 저장소가 생성됩니다.
공식 X 스레드와 공개 저장소가 올라옵니다. 코드는 커밋 세 개로 공개됩니다.
스냅샷: 스타 약 5.4k, 포크 408, 열린 항목 47개. 이미 댓글 120개가 달린 Hacker News 스레드가 돌고 있습니다.
반복해서 나온 기술적 반론은 속도가 아니었습니다. 빠진 KV cache였습니다. 몇 시간 안에 기여자들은 SM90/H20과 Ascend 910C 지원을 위한 RFC도 열었습니다. 공식 하드웨어 목록을 넘어서는 수요일 뿐, 실제 지원은 아닙니다.
우리는 DeepInfer를 실행하지 않았습니다. SM100이나 Ascend 950 하드웨어도 없습니다. 이 사이트의 모든 숫자에는 공개 출처가 붙어 있고, 검증할 수 없었던 주장은 모두 그렇게 표시했습니다.
단일 모델 DeepSeek 엔진과, API 레이어와 200개 이상의 모델을 갖춘 범용 서빙 프레임워크의 비교입니다.
비교 읽기 →가장 근접한 V4.1-Flash 비교입니다. DSpark, PD 분리, HiCache, 그리고 프리뷰 빌드라는 유의점이 있습니다.
비교 읽기 →DeepSeek의 V4.1 엔진과 NVIDIA의 범용 서빙 스택 비교입니다. 하드웨어 종속성과 API 표면이 선택을 가릅니다.
비교 읽기 →범위, 빌드 요구사항, 라이선스, 저장소 구조.
/release/ →Wide-EP, DSpark, SWA 리플레이, 비동기 스케줄링, Recipe.
/architecture/ →두 차트, 평가 수치, 그리고 그것이 증명하지 않는 것.
/benchmarks/ →누가 실행할 수 있는지, 무엇이 빠졌는지, 무엇을 직접 만들어야 하는지.
/limits/ →DeepSeek, 의료, 스마트 컨트랙트, DeepInfra.
/name/ →열여덟 개 질문과 각 질문의 출처 기반 답변.
/faq/ →