Kernel 堆疊,整合完成
FlashMLA、DeepGEMM、DeepEP、TileKernels、DeepSelect 與自訂 TileLang kernel 全部接進同一個引擎。這些元件 DeepSeek 過去已陸續釋出;這次發佈把它們串成一個引擎。
DeepInfer 是 DeepSeek 的開源推理框架,用來大規模服務 DeepSeek-V4.1-Flash。這份獨立實戰指南涵蓋 Apache-2.0 授權的本次發佈、NVIDIA SM100 與華為 Ascend 950 兩條硬件路徑、benchmark 的注意事項,以及這次發佈並未包含的 KV cache、prefill/decode 與負載平衡元件。
一套源自生產環境的推理引擎:優化 kernel、專家平行、推測解碼、滑動視窗快取復原、非同步排程,以及確定性模式。DeepSeek 同時發佈了 deepseek-recipe,這是處理 API 協定轉換與分詞的配套函式庫。
這是很難得的機會,能看到 DeepSeek 實際上如何服務一個前沿的開放權重模型:decode 階段的 Wide-EP、依信心排程的推測,以及一套以精確度換取有界重算的快取策略。即使你從不執行這些程式碼,箇中思路依然有參考價值。
FlashMLA、DeepGEMM、DeepEP、TileKernels、DeepSelect 與自訂 TileLang kernel 全部接進同一個引擎。這些元件 DeepSeek 過去已陸續釋出;這次發佈把它們串成一個引擎。
Attention 採用資料平行;MoE 部分採用專家平行。在 DeepSeek 的生產設計中,decode 會把專家分散到 64–128 張 GPU,並用冗餘副本重新平衡熱門專家。
系統會預先提出草稿 token,再由信心頭預測哪些值得驗證。DeepSeek 表示,在其生產運行點可提升 4–7% 吞吐量。
引擎不在每一層重建完整的滑動視窗快取,只重放最近的一段尾端。結果是近似值,但重算成本變得有界。
GPU 執行當前批次的同時,CPU 已在準備下一批。目標是消除 decode 步驟之間的閒置空檔——這是個工程細節,卻有實質的吞吐量價值。
NVIDIA 平台上提供批次不變推理與確定性取樣。這些功能不炫目,卻讓 benchmark 與 agent 執行結果可以被稽核。
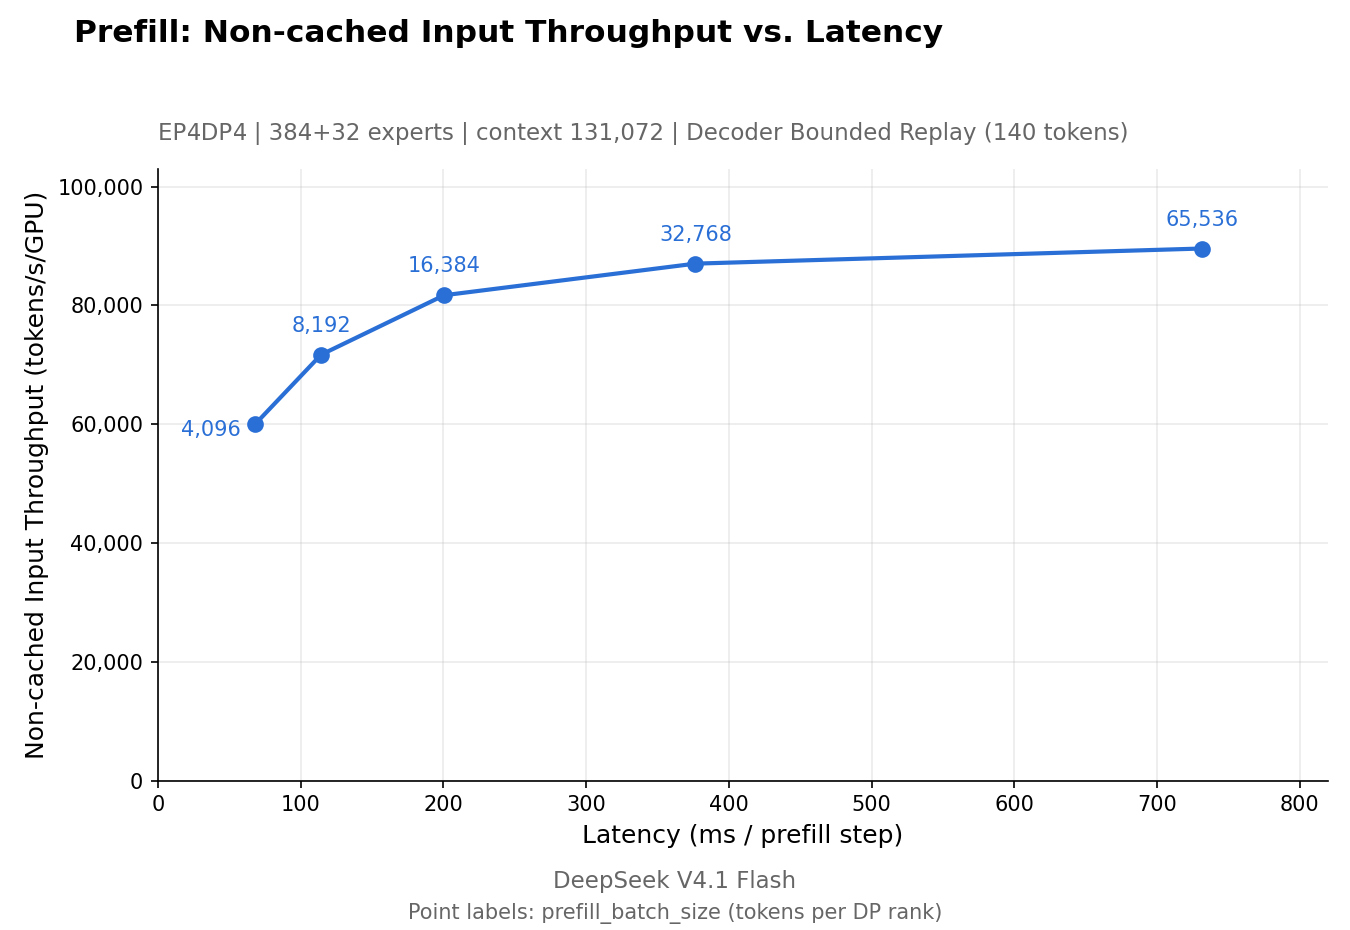
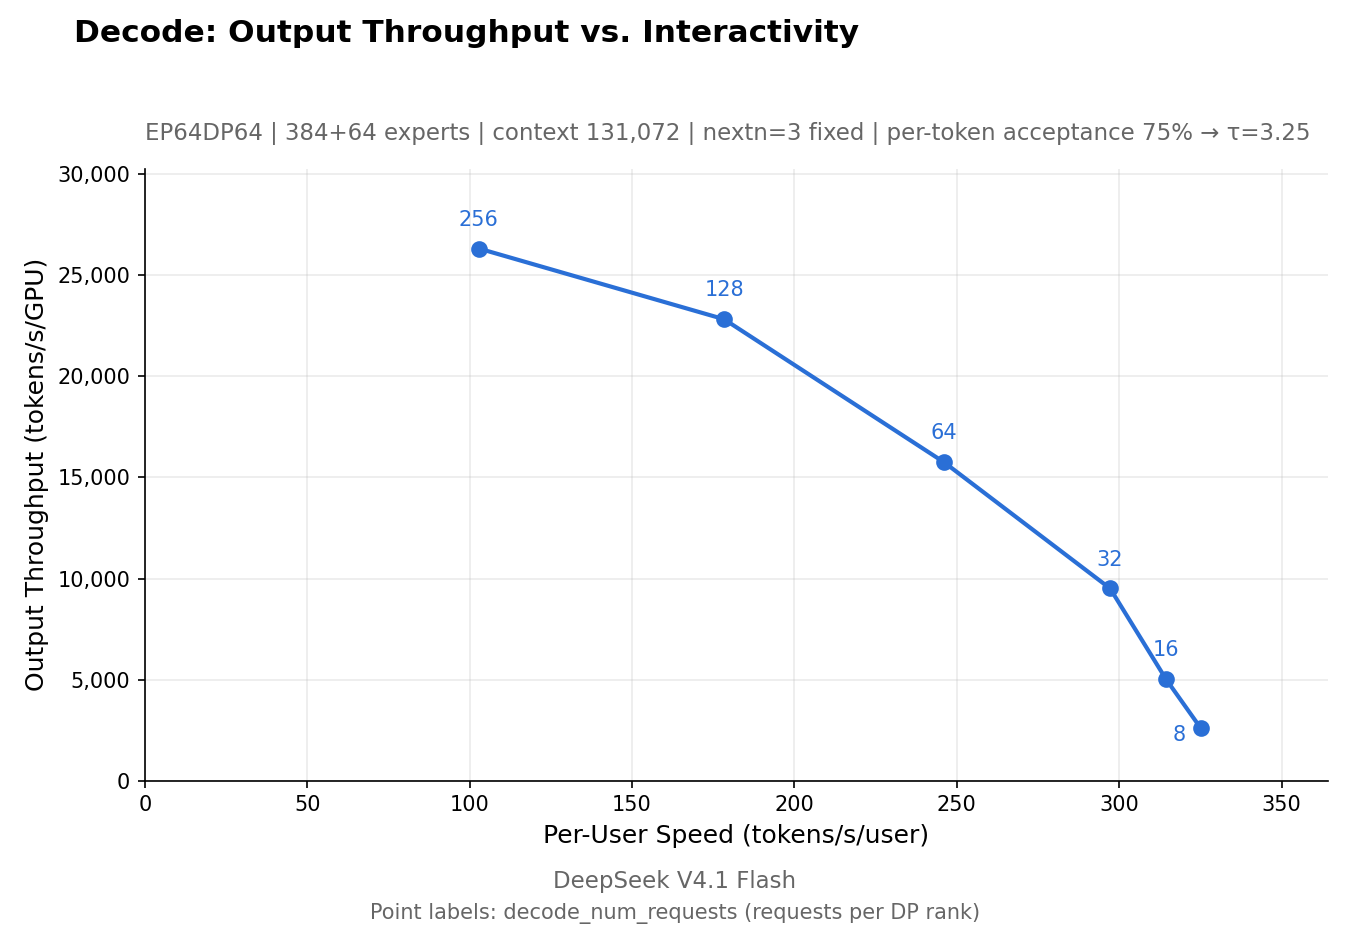
DeepInfer 是引擎,不是服務。README 對這個差別講得異常直接:完整的推理服務還需要 KV cache 系統、prefill/decode 分離,以及資料平行副本之間的負載平衡。這三項都不在本次發佈裡。
這道缺口不是醜聞,而是一條設計界線:DeepSeek 留下了與內部基礎設施綁得最緊的部分。但它確實改變了誰能用這份程式碼,以及可以對它抱什麼期待。
DeepInfer 這個名字也指涉一個無關的 2016 年醫學影像工具包,以及一個無關的 2023 年智慧合約型別推斷項目;本站只討論 DeepSeek 的 2026 年推理框架。 完整消歧義 →
DeepSeek 表示,完整開源推理引擎並不實際:程式碼已與 vLLM 分岔,又緊密耦合內部基礎設施,團隊也缺乏維護頻寬。
Ascend 基礎工程:DeepGEMM-Ascend、DeepEP-Ascend,以及 kernel 堆疊的 Ascend 後端。當時還沒有 DeepInfer。
deepseek-ai/DeepInfer 儲存庫建立。
官方 X 貼文串與公開儲存庫。程式碼隨著三個公開 commit 一起上線。
快照:約 5.4k stars、408 個 fork、47 個未結項目。Hacker News 上已有 120 則留言的討論串。
反覆出現的技術質疑並不是速度,而是缺席的 KV cache。幾小時內,貢獻者也開了 SM90/H20 與 Ascend 910C 支援的 RFC——這是超出官方硬件清單的需求,不是已交付的支援。
我們沒有執行 DeepInfer。我們沒有 SM100 或 Ascend 950 硬件。本站每個數字都註明公開來源,每個無法查證的說法都如實標示。