DeepInfer 基准测试:V4.1-Flash 的 Prefill 与 Decode
DeepInfer 为 V4.1-Flash 发布的成绩,就是两张 Pareto 图和一组评测脚本。它们有用——前提是你在看标题之前,先看清坐标轴、假设条件,以及缺失的对比。
DeepInfer 是 DeepSeek 开源的推理框架,用于大规模服务 DeepSeek-V4.1-Flash。它公开的性能证据比发布当天的讨论要窄:只有一个硬件家族上的两张 V4.1-Flash 图,加上离线评测的参考分数。目前还没有第三方复现。
DeepInfer 支持 NVIDIA SM100 GPU 和 Huawei Ascend 950 NPU,但 DeepSeek 公布的性能图表只覆盖 NVIDIA 硬件。读这些数字时,这个不对称是首先要记住的事。
两张图
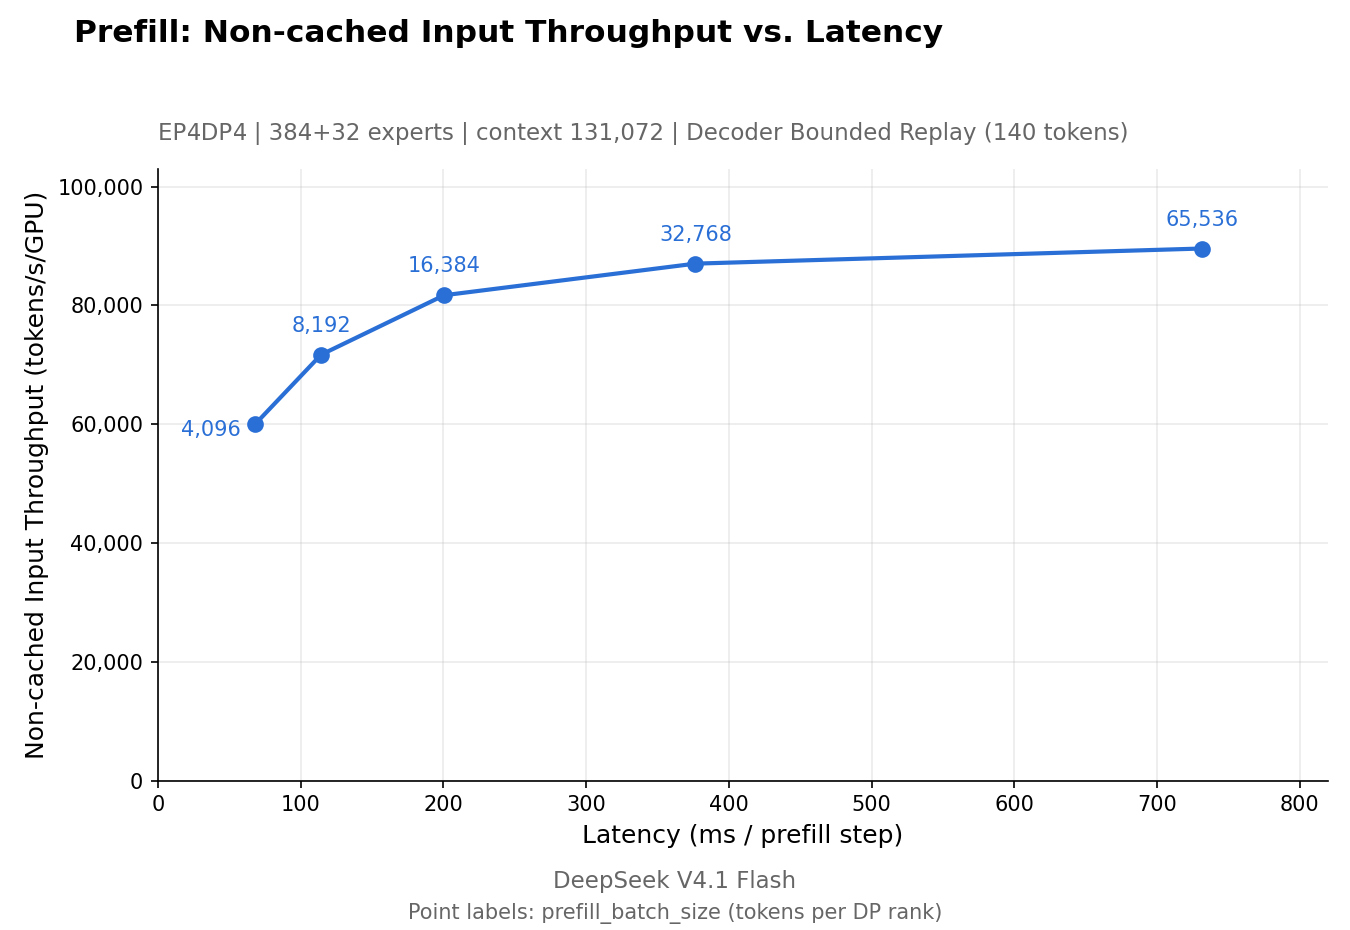
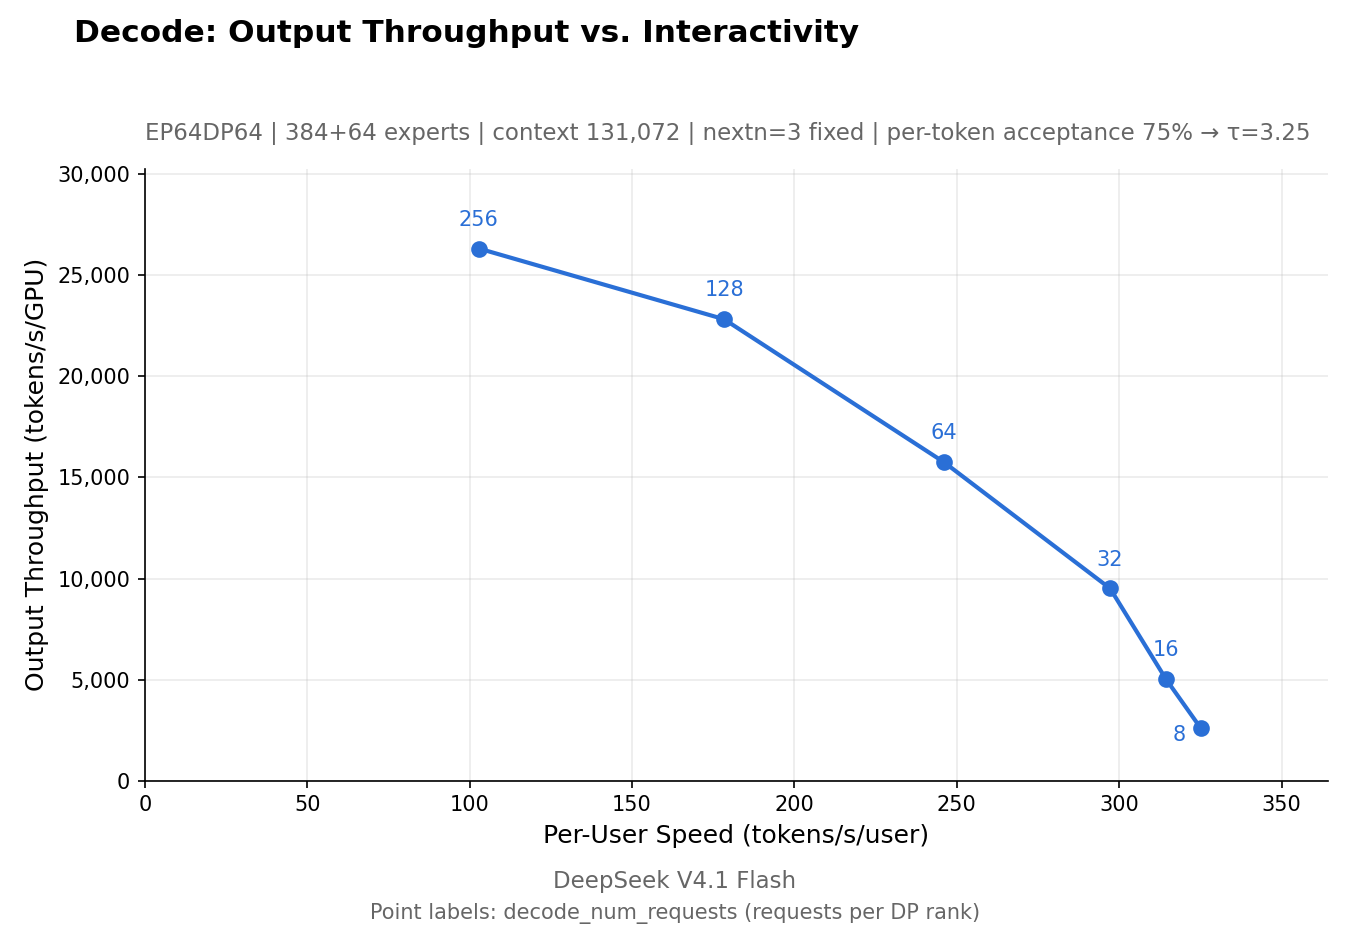
两张图都使用 131,072 token 的上下文。prefill 图用 4 块 SM100 GPU,decode 图用 64 块。每次运行都在一个 scale-up 域内。
坐标轴在说什么
| 图 | X 轴 | Y 轴 | 一个点代表什么 |
|---|---|---|---|
| Prefill | 每个 prefill 步的延迟(ms) | 非缓存输入吞吐(tokens/s/GPU) | 一个批量大小;批量越大,吞吐和延迟一起上升。 |
| Decode | 单用户速度(tokens/s/user) | 输出吞吐(tokens/s/GPU) | 每个 DP rank 的请求数;并发越高吞吐越高,但每个用户会更慢。 |
两张图都没有画端到端请求延迟。prefill 的延迟是单步延迟,不是真实请求的 time-to-first-token。decode 的单用户速度是稳态下的聚合数字,不是单次 API 调用的延迟。网络、排队、tokenization 和服务层,都在测量范围之外。
近似读数
图上并没有印吞吐数值;标签是批量大小或请求数。下面的数字是从坐标轴估读并取整的,用来理解曲线形状尚可,不适合直接拿去做采购依据。
| 图 | 数据点 | 吞吐 | 延迟 / 单用户速度 |
|---|---|---|---|
| Prefill | 批量 4,096 | 约 60k tokens/s/GPU | 约 68 ms/步 |
| Prefill | 批量 16,384 | 约 81k tokens/s/GPU | 约 200 ms/步 |
| Prefill | 批量 65,536 | 约 89k tokens/s/GPU | 约 730 ms/步 |
| Decode | 8 请求/rank | 约 2.6k tokens/s/GPU | 约 325 tokens/s/user |
| Decode | 64 请求/rank | 约 15.5k tokens/s/GPU | 约 248 tokens/s/user |
| Decode | 256 请求/rank | 约 26k tokens/s/GPU | 约 103 tokens/s/user |
评测分数
仓库还附带了三个基准的离线评测脚本。这些是模型在默认配置下的参考分数,不是引擎之间的比较。
| 基准 | 任务数 | 样本数 | Pass@1 |
|---|---|---|---|
| AIME 2026 | 30 | 每题 32 个 | 99.9% |
| GPQA Diamond | 198 | 每题 8 个 | 93.4% |
| HLE-Full | 2,500(2,158 文本 + 342 图像) | 1 | 42.6% |
这些是参考数字,不是保证。评测 README 说明,由于采样,重复运行的结果可能有小幅差异。它还指出,只有当 summary.json 中的 coverage_complete 为 true 时,Pass@1 数值才有效——对任何想复现这些数字的人,这都是个有用的细节。
评测流水线把生成与打分分开,因此你可以换一个 judge 给已有输出重新打分。默认 judge 是一个 LLM 服务;AIME 和 GPQA 可以用确定性的规则 judge,HLE 不行,因为它一半以上的答案是自由文本。
这些数字不是什么
- 不是与 vLLM 或 SGLang 的对比。这两个项目各自发布过 V4.1-Flash 优化文章,但硬件和负载不同。目前没有公开的正面对比。
- 不是 Ascend 950 的数据。README 说支持 Ascend 950,但图表只有 SM100。
- 不是成本模型。tokens/s/GPU 不等于每百万 token 的美元成本。成本还要算利用率、电费、折旧、网络、存储和故障开销。
- 不是真实负载的保证。图表使用固定的 131,072 token 上下文和固定的请求模式。你的 prompt 分布、输出长度和缓存命中率都会不同。
- 没有经过独立复现。截至 2026-10-20 11:30 UTC,我们没有找到第三方复现。
如何复现
仓库提供了一个扫描工具:
# Decode:扫描每个 DP rank 的请求数,nextn=3,按 75% 接受率绘图
bash examples/sweep/run_sweep.sh decode ce-128k 131072 3 0.75

# Prefill:扫描批量大小
bash examples/sweep/run_sweep.sh prefill pe-128k 131072

# Encoder:固定图像尺寸,扫描每批图像数
bash examples/sweep/run_sweep.sh encoder ve-800
扫描结果会写入 results.jsonl,并在 sweeps/<tag>/ 下生成一张 Pareto PNG。多节点运行时,只有持有 dp_rank 0 的节点写 JSONL,其它节点完成后直接退出。examples 的 README 提醒,profiler 会干扰稳态读数,因此扫描时设置 PROFILE=0。
至于评测脚本,先把数据集放到文档指定的路径,然后运行 bash eval/aime/run.sh、bash eval/gpqa/run.sh 或 bash eval/hle/run.sh。脚本不会替你下载数据集。
生产规模的说法
DeepSeek 称单个集群每天服务 155 万亿 token,在低谷电价下整体收入为每 GPU 小时 38 美元。文章没有披露集群规模、GPU 构成和统计窗口。收入不是利润,这个数字也无法用来推算单 token 成本。
这是最容易被误引的数字。它是对生产规模的陈述,不是基准测试结果,也不能和图上的 tokens/s/GPU 直接比较。如果你要算单位经济性,需要集群规模、利用率、能源成本和摊销方式——这些都不在发布文章里。
我们还想要什么
- 一份 SM100 上的第三方复现,附确切的 commit 和配置。
- Ascend 950 的吞吐与稳定性数据,哪怕只是单节点运行。
- 在相同硬件、上下文和负载下,与 vLLM、SGLang 的正面对比。
- 包含 KV cache 和负载均衡层的端到端服务基准——也就是发布略去的那部分。
- 在明确利用率和电价前提下的每百万 token 成本。
在那之前,正确的读法是:这两张图说明 DeepSeek 的引擎能以合理的方式用延迟换吞吐;它们没有告诉你你自己的集群会跑出什么结果。
下一篇:更详细的推理基准阅读指南、缺失部分意味着什么,或者几篇对比:DeepInfer vs vLLM、vs SGLang、vs TensorRT-LLM。