DeepInfer Field Notes 独立 / ファン制作
FIG. 01 — リリース資料 / 2026.10

DeepInfer: DeepSeekのV4.1-Flash推論フレームワーク

DeepInferは、DeepSeek-V4.1-Flashを大規模にサービングするためのDeepSeekのオープンソース推論フレームワークだ。本サイトは独立系のフィールドガイドとして、Apache-2.0ライセンスでの公開、NVIDIA SM100とHuawei Ascend 950への対応、ベンチマークの注意点、そしてリリースに含まれないKV cache、prefill/decode、ロードバランシングの各部分を扱う。

公開2026年10月20日UTC
コードライセンスApache-2.0重み: MIT
モデルV4.1-Flashのみ
ハードウェアSM100 / Ascend 950Linuxのみ
対象範囲オフラインエンジンホスト型APIではない
スナップショット 2026-10-20 11:30 UTC/ 公開資料ベースの読解/ 実機検証なし/ 独立系・ファンメイド
要約

エンジンと、境界線と、注釈付きで読むべき数字。

読了目安: 6分

何であるか

実運用から生まれた推論エンジンだ。最適化カーネル、expert parallelism、投機的デコード、sliding-window方式のキャッシュ復元、非同期スケジューリング、決定論的モードを備える。DeepSeekは併せて、APIプロトコル変換とトークナイズを担うライブラリdeepseek-recipeも公開した。

何でないか

  • モデルではない。モデルはV4.1-Flashだ。
  • ホスト型APIでも、OpenAI互換サーバーでもない。
  • 完全なサービングスタックではない。KV cache、PD分離、ロードバランシングが欠けている。
  • 他のモデル向けの汎用エンジンではない。

なぜ重要か

フロンティア級のオープンウェイトモデルをDeepSeekが実際にどうサービングしているかを覗ける、貴重な事例だ。decodeでのWide-EP、信頼度に基づいて投機をスケジュールする仕組み、正確さと引き換えに再計算を有界にするキャッシュ方針。コードを一度も動かさなくても、アイデア自体に学ぶ価値がある。

境界線を一文で。 DeepInferはオフライン推論エンジンであり、ホスト型APIでもモデルでもない。完全なオンラインサービスに必要なKV cacheシステム、prefill/decode分離、データ並列レプリカ間のロードバランシングは、このリリースには含まれていない。
対象範囲

実際に公開されたもの

公式README + Q&A
01 / カーネル

組み上げられたカーネルスタック

FlashMLA、DeepGEMM、DeepEP、TileKernels、DeepSelect、そして独自のTileLangカーネルが1つのエンジンに組み込まれている。部品自体は以前から公開されていたが、今回それらが1つのエンジンとして統合された。

02 / 並列化

Wide-EPとEPLB

attentionはデータ並列、MoE部分はexpert parallelismを使う。DeepSeekの本番設計では、decodeはエキスパートを64〜128基のGPUに分散し、ホットなエキスパートを冗長コピーで平準化する。

03 / 投機

DSparkと可変長検証

draftトークンを先に提案し、confidence headがどれを検証する価値があるか予測する。DeepSeekは本番の動作点でスループット+4〜7%と報告している。

04 / キャッシュ

SWA bounded replay

レイヤーごとにsliding-windowキャッシュ全体を再構築する代わりに、直近の末尾だけを再実行する。結果は近似になるが、再計算コストは有界に収まる。

05 / スケジューリング

デフォルトで非同期

GPUが現在のバッチを実行している間に、CPUが次のバッチを準備する。狙いはdecodeステップ間の遊び時間をなくすことで、スループットに効く地味だが重要な実装詳細だ。

06 / 再現性

決定論的モード

バッチ不変推論と決定論的サンプリングがNVIDIA上で利用できる。派手さはないが、ベンチマークとエージェント実行を監査可能にする機能だ。
含まれるもの

  • DeepSeek-V4.1-Flashのオフライン推論
  • 最適化カーネルとモデル/サンプラーのランタイム
  • Attention DP、balanced CP、MoE EP + EPLB
  • DSpark、SWA bounded replay、非同期スケジューリング
  • バッチ不変モードと決定論的モード(NVIDIA)
  • 構造化出力: regex、JSON Schema、EBNF
  • deepseek-recipe(別リポジトリ、MIT)

含まれないもの

  • KV cacheシステム
  • VE / Prefill / Decodeの分離
  • データ並列レプリカ間のロードバランシング
  • ユーザー向けのオンラインAPI
  • 他のDeepSeekモデルのサポート
  • 公開されたAscend 950の性能データ
  • チャートの第三者による再現
数字

ベンチマークと、その注釈

公式チャート / コンテキスト131,072
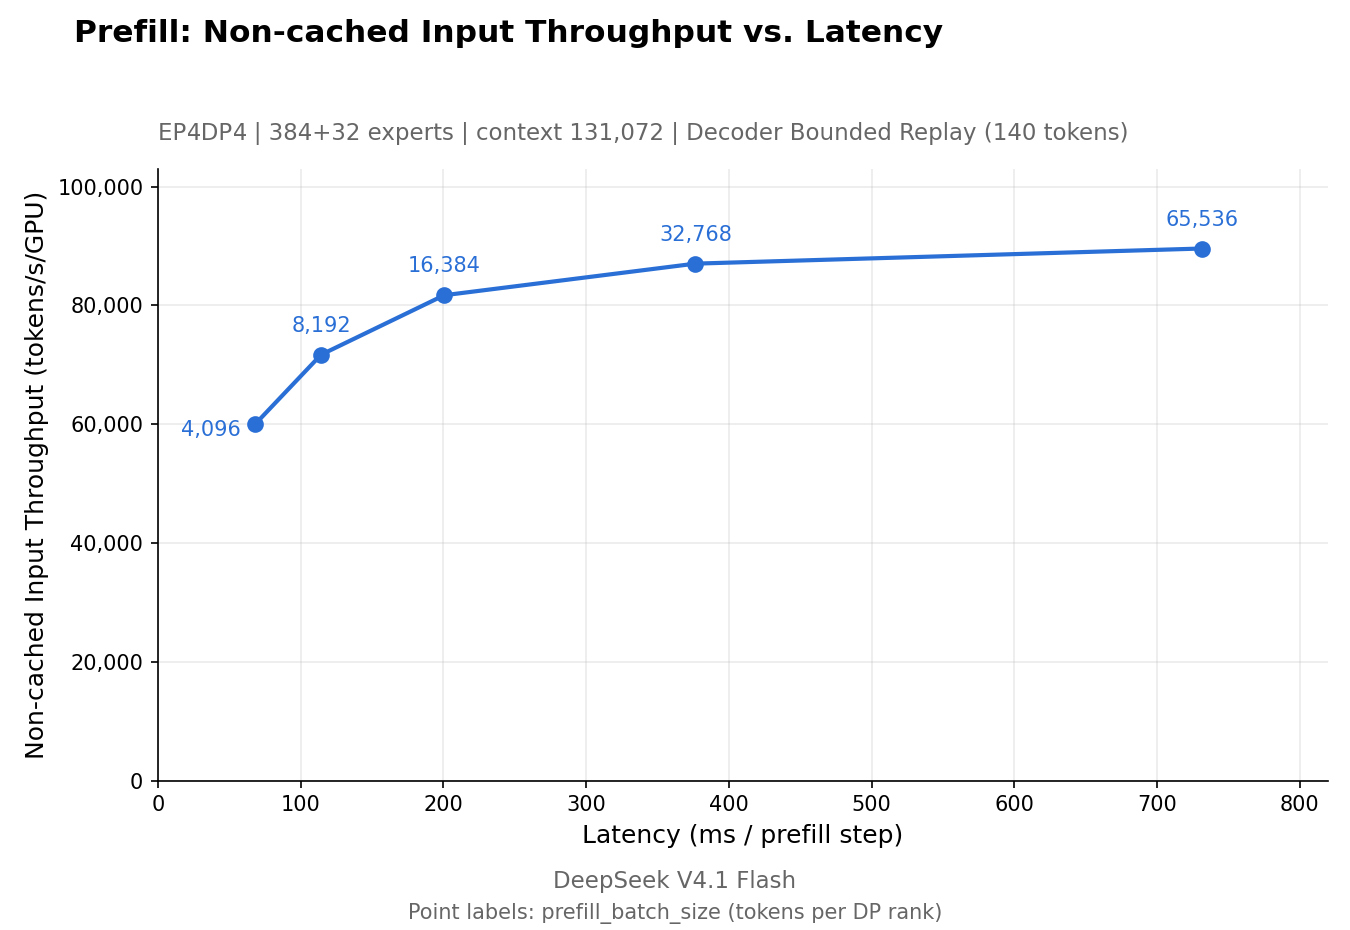
DeepInferのprefill Paretoチャート: SM100 4基での非キャッシュ入力スループットとレイテンシ
Prefill。 4×SM100、EP4DP4、384+32エキスパート、131,072トークンのコンテキスト。ラベルはバッチサイズであり、スループットの値ではない。出典: DeepInfer README(Apache-2.0)。
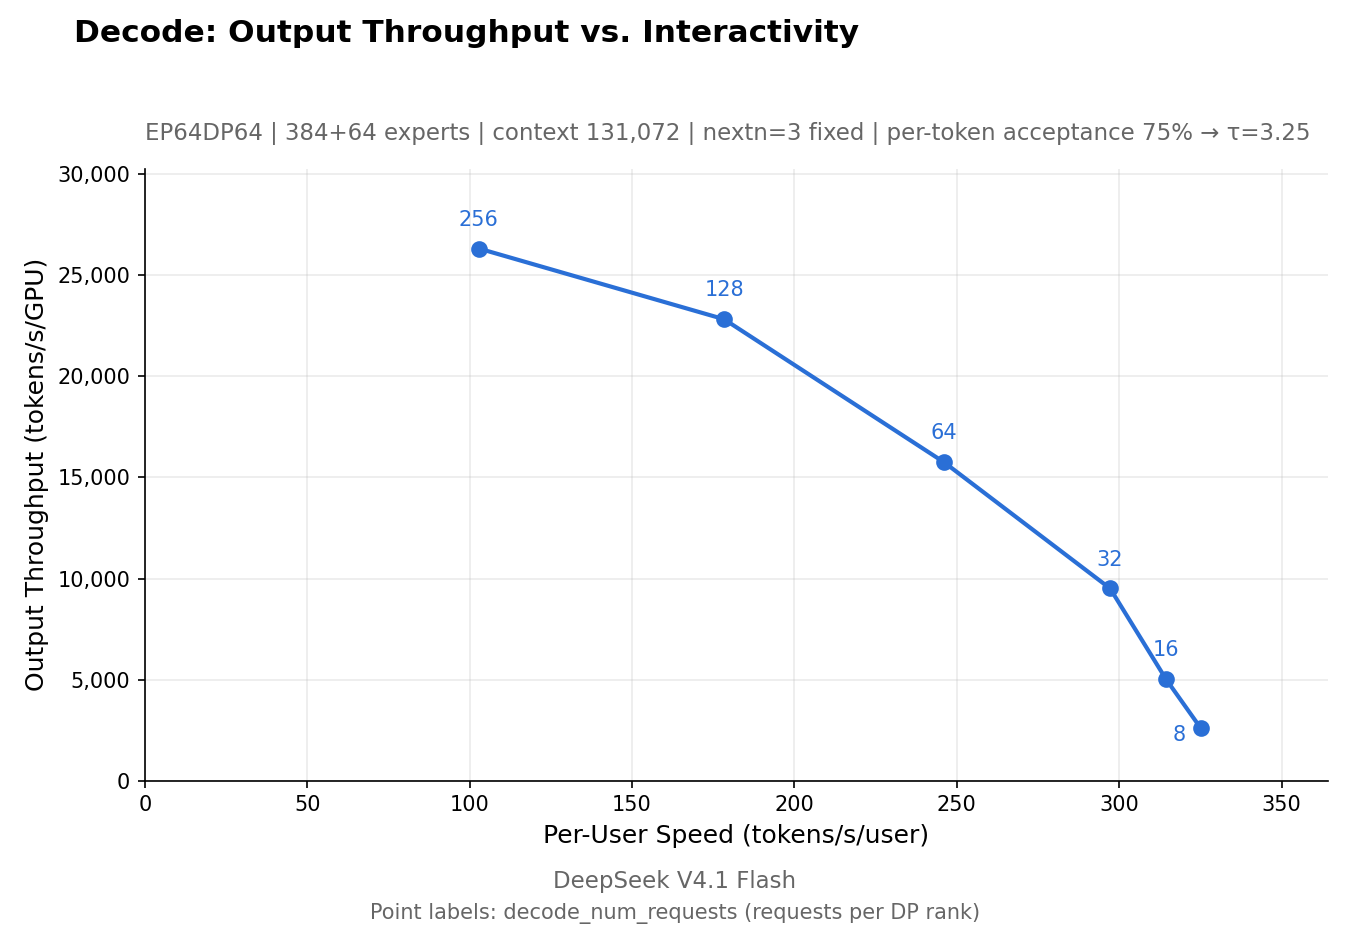
DeepInferのdecode Paretoチャート: SM100 64基での出力スループットとユーザーあたり速度
Decode。 64×SM100、EP64DP64、384+64エキスパート、131,072トークンのコンテキスト、nextn=3固定、draft受容率75%。出典: DeepInfer README(Apache-2.0)。
131,072 両チャートのコンテキスト長 モデル本来の最大100万トークンではない。
4 + 64 prefill + decodeに使うSM100 GPUの数 いずれも単一のスケールアップドメイン内。
0 確認できた第三者による再現 2026-10-20 11:30 UTC時点。
見るべきは軸であり、見出しではない。 Prefillはスループット対ステップあたりレイテンシ。Decodeはスループット対ユーザーあたり速度。どちらも、エンドツーエンドのリクエストレイテンシやトークンあたりコスト、あなたのワークロードについての約束ではない。decodeチャートはdraft受容率75%も前提にしている。予測しにくいテキストでは利得は小さくなる。
欠落部分

多くのローンチ記事が飛ばした部分

欠けている3つの部品

DeepInferはエンジンであり、サービスではない。READMEはこの違いについて異例なほど率直だ。完全な推論サービスには、KV cacheシステム、prefill/decode分離、データ並列レプリカ間のロードバランシングも必要になる。この3つはいずれもリリースに含まれていない。

欠落は不祥事ではない。設計上の境界線だ。DeepSeekは自社インフラと最も強く結合した部分を手元に残した。だがその選択は、誰がこのコードを使えるのか、何を期待できるのかを変える。

自分で作ることになるもの

  • リクエストとマシンをまたいで生き残るprefix/KV cache
  • 転送とルーティングを備えた、分離されたprefillプールとdecodeプール
  • リクエスト数とキャッシュ長の両方を意識するロードバランシング
  • APIサーバー、認証、クォータ、課金、可観測性
名称確認

読んでいるのはどのDeepInferか

1つの名前、複数のプロジェクト
DeepSeek2026 · LLM推論 · 本サイト
医療2016 · 3D Slicer · 無関係
スマートコントラクト2023 · バイトコード型推論 · 無関係
DeepInfra綴りが異なる · 別会社

DeepInferという名前は、無関係な2016年の医療画像ツールキットと、無関係な2023年のスマートコントラクト型推論プロジェクトも指す。本サイトが扱うのはDeepSeekの2026年の推論フレームワークのみだ。 名称の識別ページへ →

ローンチ記録

ここまでの経緯

時刻はUTC
  1. 2025-04

    DeepSeekは推論エンジン全体の公開は現実的でないと説明する。コードがvLLMから大きく分岐し、社内インフラと結合しており、チームにメンテナンスの余力がないためだ。

  2. 2026-09-30

    Ascend向けの地ならし。DeepGEMM-Ascend、DeepEP-Ascend、カーネルスタック向けのAscendバックエンドが登場。DeepInferはまだない。

  3. 2026-10-16

    リポジトリdeepseek-ai/DeepInferが作成される。

  4. 2026-10-20 09:30

    公式Xスレッドと公開リポジトリ。コードは3つの公開コミットとともに登場する。

  5. 2026-10-20 11:26

    スナップショット: スター約5.4k、フォーク408、オープン項目47。120コメントのHacker Newsスレッドもすでに動いている。

コミュニティの反応

繰り返し出た技術的な異議は速度の話ではなかった。欠けているKV cacheについてだった。数時間のうちに、コントリビューターはSM90/H20とAscend 910CサポートのRFCも起票している。これは公式のハードウェア一覧を超える要望であり、提供済みのサポートではない。

やらなかったこと

DeepInferは実行していない。SM100もAscend 950も手元にない。本サイトの数字はすべて公開資料に出典を紐づけており、検証できなかった主張にはその旨を明記している。

比較

DeepInferと10のサービングフレームワーク

VS / VLLM

DeepInfer vs vLLM

1モデル専用のDeepSeekエンジンと、APIレイヤーと200以上のモデルを備えた汎用サービングフレームワーク。

比較を読む →
VS / SGLANG

DeepInfer vs SGLang

V4.1-Flashでは最も近い比較対象。DSpark、PD分離、HiCache、そしてプレビュービルドという注意点。

比較を読む →
VS / TENSORRT-LLM

DeepInfer vs TensorRT-LLM

DeepSeekのV4.1エンジンとNVIDIAの汎用サービングスタック。決め手はハードウェアのロックインとAPIの範囲。

比較を読む →
次に読む

さらに深く

6項目
↑