DeepInferのベンチマーク: V4.1-Flashのprefillとdecode
DeepInferのV4.1-Flash向けローンチ数値は、2つのParetoチャートと評価スクリプトの一式だ。見出しより先に軸、前提、欠けている比較を確認してはじめて、役に立つ。
DeepInferは、DeepSeek-V4.1-Flashを大規模にサービングするためのDeepSeekのオープンソース推論フレームワークだ。公開されている性能の裏づけは、ローンチ時の話題より狭い。1つのハードウェアファミリ上でのV4.1-Flashのチャート2枚と、オフライン評価の参照スコアだけである。第三者の再現はまだ存在しない。
DeepInferはNVIDIA SM100 GPUとHuawei Ascend 950 NPUをサポートするが、DeepSeekが公開した性能チャートはNVIDIAハードウェアのみを対象としている。数値を読むとき、まずこの非対称性を頭に置いておきたい。
2つのチャート
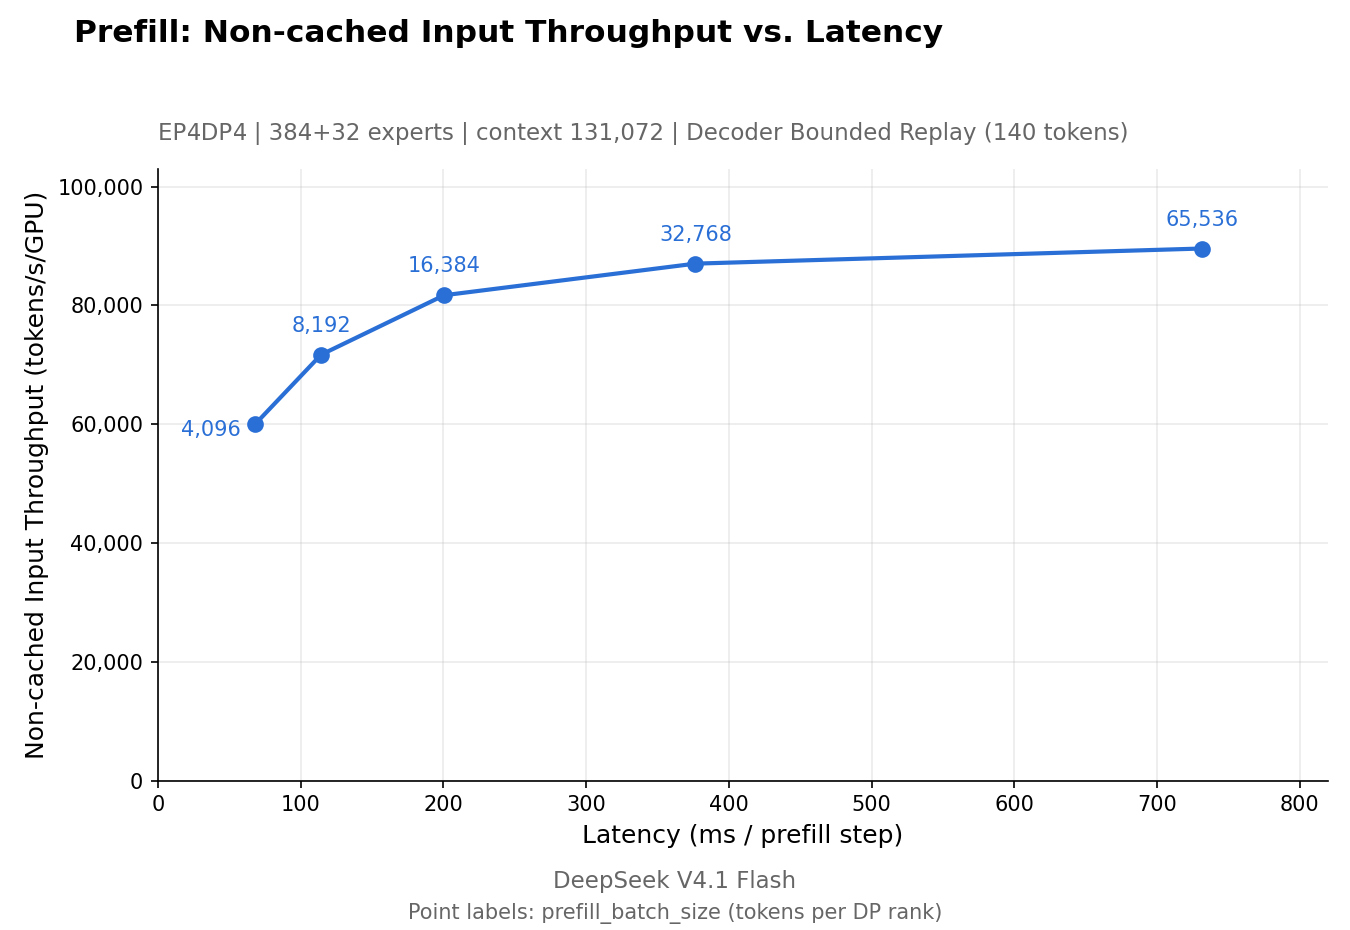
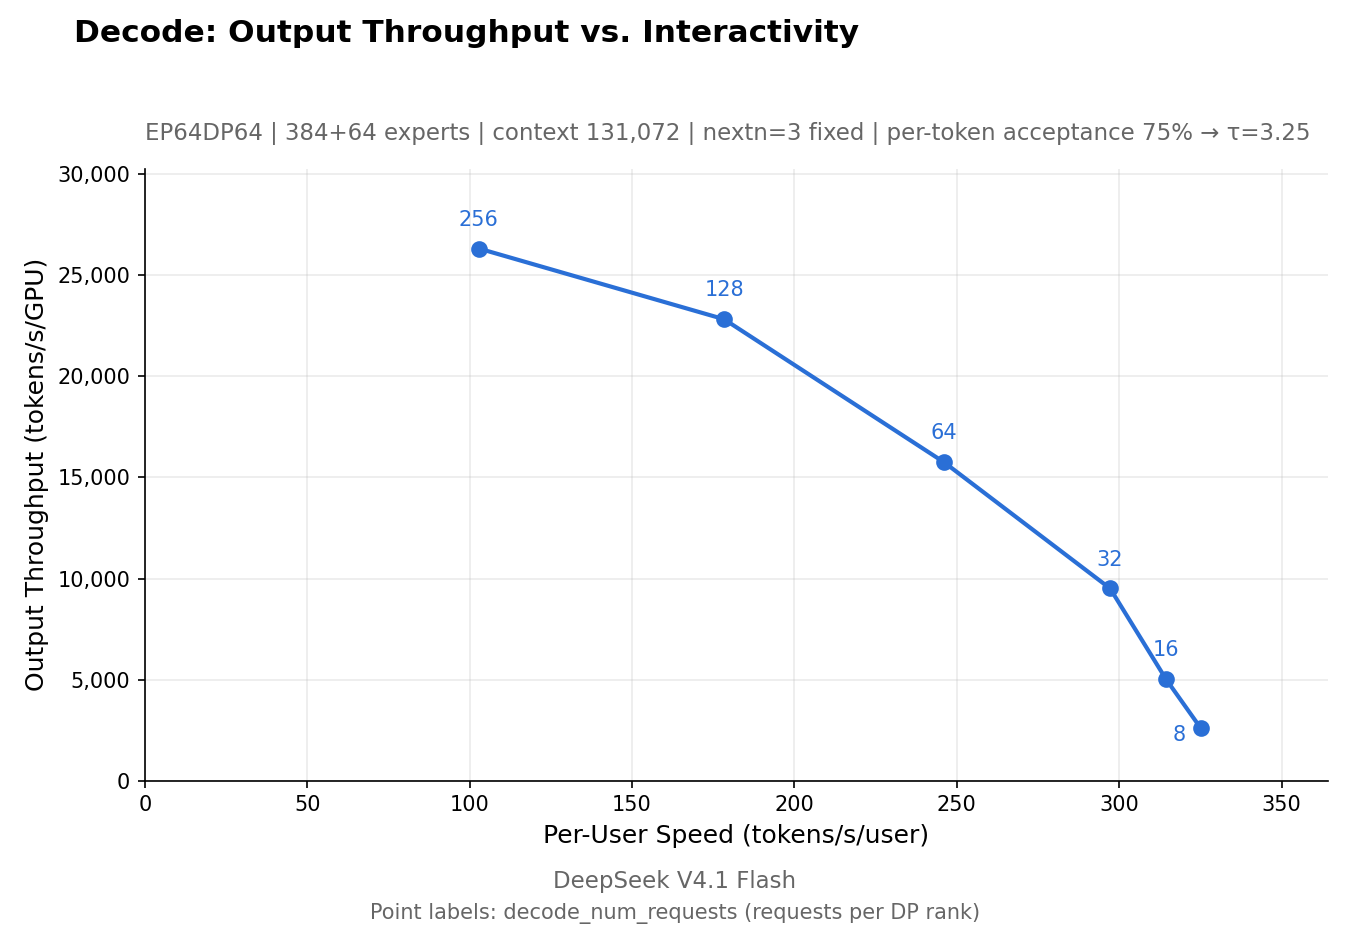
どちらのチャートも131,072トークンのコンテキストを使う。prefillはSM100 4基、decodeは64基だ。各実行は単一のスケールアップドメイン内で行われている。
軸の意味
| チャート | X軸 | Y軸 | 点が表すもの |
|---|---|---|---|
| Prefill | prefill 1ステップあたりのレイテンシ(ms) | 非キャッシュ入力スループット(tokens/s/GPU) | バッチサイズ。バッチを大きくするとスループットとレイテンシが同時に上がる。 |
| Decode | ユーザーあたり速度(tokens/s/user) | 出力スループット(tokens/s/GPU) | DPランクあたりのリクエスト数。並列リクエストを増やすとスループットは上がるが、各ユーザーは遅くなる。 |
どちらのチャートも、エンドツーエンドのリクエストレイテンシを描いていない。prefillのレイテンシはステップあたりの値であり、実際のリクエストのTTFTではない。decodeのユーザーあたり速度は定常状態の集計値であり、1回のAPI呼び出しのレイテンシではない。ネットワーク、キューイング、トークナイズ、サービング層は測定の外にある。
おおよその読み取り
チャートにはスループットの値が印字されていない。ラベルはバッチサイズかリクエスト数だ。以下の数値は軸から読み取って丸めたものである。形を理解するには役立つが、調達の判断には使えない。
| チャート | 点 | スループット | レイテンシ / ユーザーあたり速度 |
|---|---|---|---|
| Prefill | バッチ4,096 | ~60k tokens/s/GPU | ~68 ms/step |
| Prefill | バッチ16,384 | ~81k tokens/s/GPU | ~200 ms/step |
| Prefill | バッチ65,536 | ~89k tokens/s/GPU | ~730 ms/step |
| Decode | 8リクエスト/ランク | ~2.6k tokens/s/GPU | ~325 tokens/s/user |
| Decode | 64リクエスト/ランク | ~15.5k tokens/s/GPU | ~248 tokens/s/user |
| Decode | 256リクエスト/ランク | ~26k tokens/s/GPU | ~103 tokens/s/user |
評価スコア
リポジトリには3つのベンチマーク向けのオフライン評価スクリプトも含まれている。これはデフォルト構成でのモデルの参照スコアであり、エンジン間の比較ではない。
| ベンチマーク | タスク数 | サンプル数 | Pass@1 |
|---|---|---|---|
| AIME 2026 | 30 | タスクあたり32 | 99.9% |
| GPQA Diamond | 198 | タスクあたり8 | 93.4% |
| HLE-Full | 2,500(テキスト2,158 + 画像342) | 1 | 42.6% |
これらは参照値であり、保証ではない。評価用READMEは、サンプリングのため反復実行で小さな差が出うるとしている。また、Pass@1の値はsummary.jsonのcoverage_completeがtrueのときのみ有効だと注記している。再現する人には有用な詳細だ。
評価パイプラインは生成と採点を分離しているので、既存の出力を別のジャッジで採点し直せる。デフォルトのジャッジはLLMサービスだ。AIMEとGPQAには決定論的なルールベースのジャッジも用意されているが、HLEにはない。回答の半数以上が自由記述だからだ。
これらの数値が示さないもの
- vLLMやSGLangとの比較ではない。 どちらのプロジェクトも独自のV4.1-Flash最適化記事を持ち、ハードウェアもワークロードも異なる。公開された直接対決は存在しない。
- Ascend 950のデータではない。 READMEはAscend 950をサポートするとしているが、チャートはSM100のみだ。
- コストモデルではない。 tokens/s/GPUは100万トークンあたりの金額ではない。コストには利用率、電力、減価償却、ネットワーク、ストレージ、障害時の余裕が必要だ。
- 実ワークロードの保証ではない。 チャートは131,072トークンの固定コンテキストと固定のリクエストパターンを使う。プロンプト分布、出力長、キャッシュヒット率はあなたの環境で異なる。
- 独立に再現されていない。 2026-10-20 11:30 UTC時点で、第三者による再現は見つかっていない。
再現方法
リポジトリにはスイープ用のハーネスがある。
# Decode: DPランクあたりのリクエスト数をスイープ、nextn=3、受容率75%で描画
bash examples/sweep/run_sweep.sh decode ce-128k 131072 3 0.75

# Prefill: バッチサイズをスイープ
bash examples/sweep/run_sweep.sh prefill pe-128k 131072

# Encoder: 画像サイズを固定し、バッチあたりの画像数をスイープ
bash examples/sweep/run_sweep.sh encoder ve-800スイープはresults.jsonlとParetoのPNGをsweeps/<tag>/以下に書き出す。マルチノード実行では、dp_rank 0を持つノードだけがJSONLを書き、他のノードは終了後に抜ける。examplesのREADMEは、プロファイラが定常状態の測定値を乱すと警告しており、スイープはPROFILE=0で実行される。
評価スクリプトについては、データセットを指定のパスに置き、bash eval/aime/run.sh、bash eval/gpqa/run.sh、bash eval/hle/run.shを実行する。スクリプトがデータセットをダウンロードしてくれるわけではない。
本番環境の主張
DeepSeekは、1つのクラスタで1日155兆トークンをサービングし、オフピーク価格でGPU時間あたり38米ドルの収益を上げていると述べている。記事はクラスタ規模、GPU構成、測定期間を開示していない。収益は利益ではなく、この数字からトークンあたりコストを導くことはできない。
これが最も誤って引用されやすい数字だ。本番規模についての主張であり、ベンチマークの結果ではなく、チャートのtokens/s/GPUと比較できるものでもない。ユニットエコノミクスが必要なら、クラスタ規模、利用率、電力コスト、償却を尋ねるべきだ。どれもローンチ記事には載っていない。
次に欲しいもの
- SM100上での第三者による再現。コミットと構成を明示したもの。
- Ascend 950のスループットと安定性のデータ。単一ノードの実行でもよい。
- 同じハードウェア、コンテキスト、ワークロードでのvLLM、SGLangとの直接対決。
- KV cacheとロードバランシング層を含むエンドツーエンドのサービングベンチマーク。リリースが省いた部分だ。
- 利用率と電力価格を明示した、100万トークンあたりのコスト。
それまでは、こう読むのが正しい。これらのチャートは、DeepSeekのエンジンがレイテンシとスループットを妥当な形で交換できることを示している。あなたのクラスタがどうなるかは語っていない。
次は推論ベンチマークの読み方の詳解、欠けている部分の意味、あるいは比較へ: DeepInfer vs vLLM、vs SGLang、vs TensorRT-LLM。