DeepInfer 벤치마크: V4.1-Flash 프리필과 디코드
DeepInfer의 V4.1-Flash 출시 수치는 파레토 차트 두 장과 평가 스크립트 묶음입니다. 헤드라인보다 축, 가정, 빠진 비교를 먼저 읽는다면 유용한 자료입니다.
DeepInfer는 DeepSeek-V4.1-Flash를 대규모로 서빙하기 위한 DeepSeek의 오픈소스 추론 프레임워크입니다. 공개된 성능 근거는 출시 당시의 논의보다 좁습니다. 한 하드웨어 계열에서 측정한 V4.1-Flash 차트 두 장과 오프라인 평가 참조 점수가 전부입니다. 아직 제3자가 재현한 사례는 없습니다.
DeepInfer는 NVIDIA SM100 GPU와 Huawei Ascend 950 NPU를 지원하지만, DeepSeek가 공개한 성능 차트는 NVIDIA 하드웨어만 다룹니다. 숫자를 읽을 때 가장 먼저 기억해야 할 비대칭입니다.
두 차트
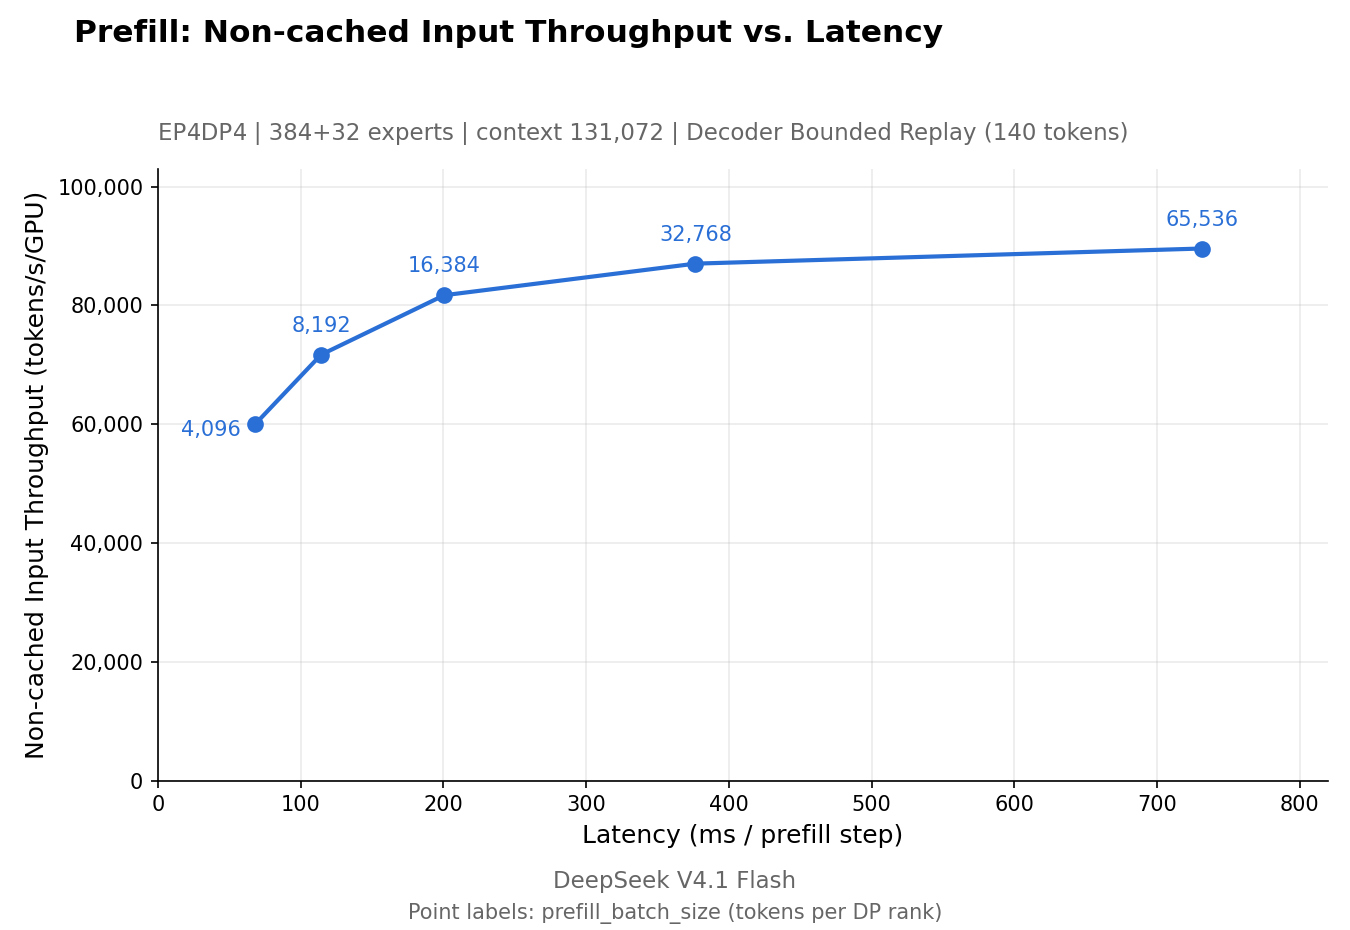
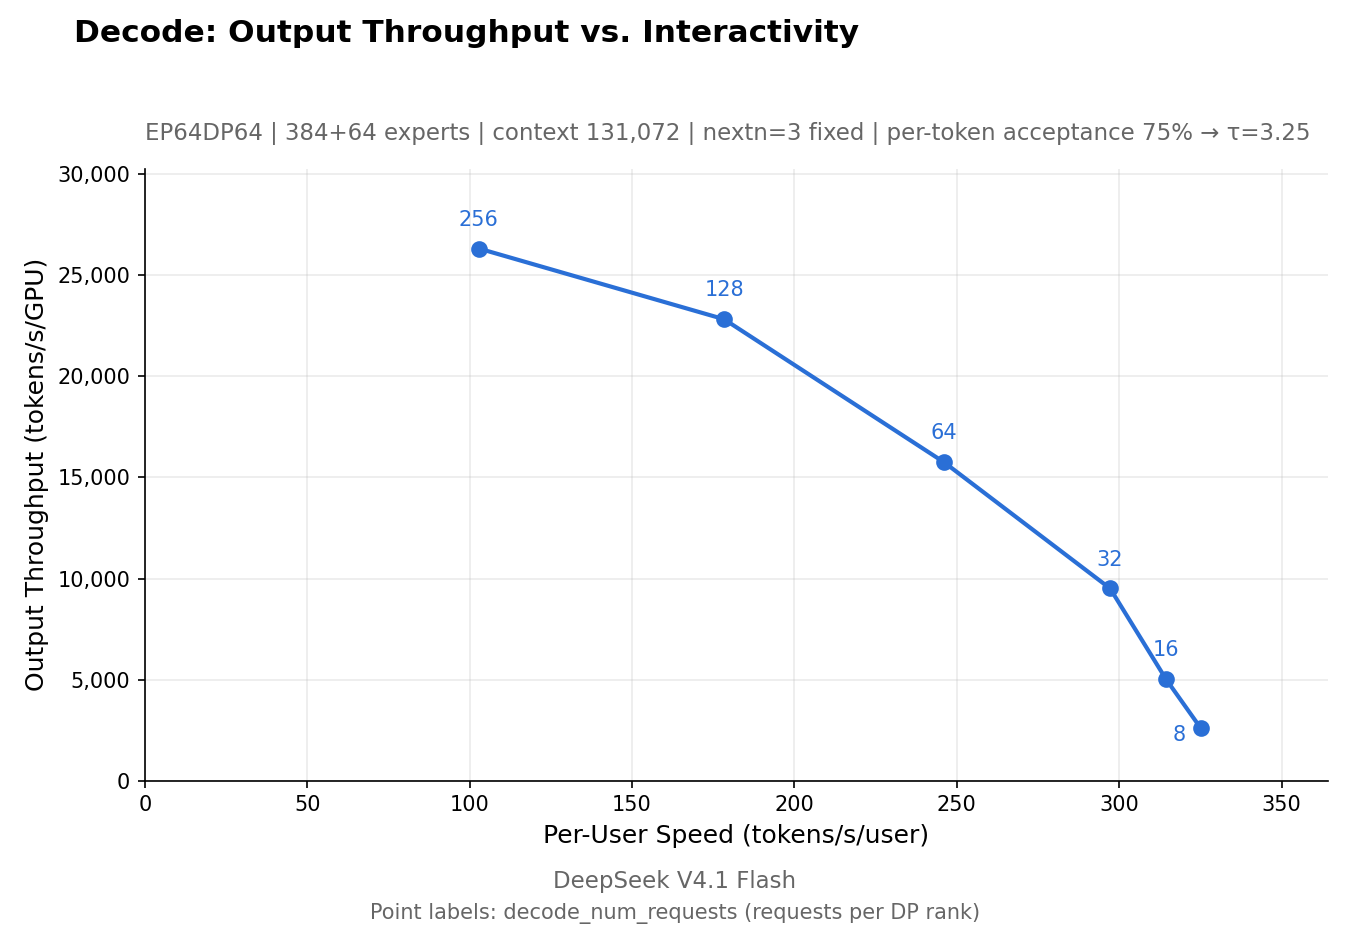
두 차트 모두 131,072 토큰 컨텍스트를 사용합니다. 프리필 차트는 SM100 GPU 4개, 디코드 차트는 64개를 씁니다. 각 실행은 하나의 스케일업 도메인 안에서 이루어졌습니다.
축의 의미
| 차트 | X축 | Y축 | 점이 나타내는 것 |
|---|---|---|---|
| 프리필 | 프리필 스텝당 지연 시간(ms) | 비캐시 입력 처리량(tokens/s/GPU) | 배치 크기입니다. 배치가 커지면 처리량과 지연 시간이 함께 올라갑니다. |
| 디코드 | 사용자당 속도(tokens/s/user) | 출력 처리량(tokens/s/GPU) | DP 랭크당 요청 수입니다. 동시 요청이 많아지면 처리량은 오르지만 사용자별 속도는 느려집니다. |
어느 차트도 엔드투엔드 요청 지연을 그리지 않습니다. 프리필 지연은 스텝당 값이지 실제 요청의 첫 토큰 지연 시간이 아닙니다. 디코드의 사용자당 속도는 정상 상태의 집계 값이지 API 호출 한 건의 지연이 아닙니다. 네트워크, 큐잉, 토큰화, 서빙 계층은 측정 범위 밖입니다.
근사 판독값
차트에는 처리량 값이 찍혀 있지 않습니다. 라벨은 배치 크기나 요청 수입니다. 아래 숫자는 축에서 읽어 반올림한 값입니다. 형태를 이해하는 데는 유용하지만 구매 판단에 쓸 값은 아닙니다.
| 차트 | 지점 | 처리량 | 지연 시간 / 사용자당 속도 |
|---|---|---|---|
| 프리필 | 4,096 배치 | ~60k tokens/s/GPU | ~68 ms/step |
| 프리필 | 16,384 배치 | ~81k tokens/s/GPU | ~200 ms/step |
| 프리필 | 65,536 배치 | ~89k tokens/s/GPU | ~730 ms/step |
| 디코드 | 랭크당 8 요청 | ~2.6k tokens/s/GPU | ~325 tokens/s/user |
| 디코드 | 랭크당 64 요청 | ~15.5k tokens/s/GPU | ~248 tokens/s/user |
| 디코드 | 랭크당 256 요청 | ~26k tokens/s/GPU | ~103 tokens/s/user |
평가 수치
저장소에는 세 가지 벤치마크용 오프라인 평가 스크립트도 들어 있습니다. 이는 기본 구성에서 모델이 낸 참조 점수이지, 엔진 간 비교가 아닙니다.
| 벤치마크 | 과제 | 샘플 | Pass@1 |
|---|---|---|---|
| AIME 2026 | 30 | 과제당 32 | 99.9% |
| GPQA Diamond | 198 | 과제당 8 | 93.4% |
| HLE-Full | 2,500(텍스트 2,158 + 이미지 342) | 1 | 42.6% |
참조 값이지 보장이 아닙니다. 평가 README는 샘플링 때문에 반복 실행 시 값이 조금씩 달라질 수 있다고 밝힙니다. 또한 Pass@1 값은 coverage_complete가 summary.json에서 true일 때만 유효하다고 적고 있습니다. 숫자를 재현하려는 사람에게 유용한 세부 사항입니다.
평가 파이프라인은 생성과 채점을 분리하므로, 기존 출력을 다른 판정자로 다시 채점할 수 있습니다. 기본 판정자는 LLM 서비스입니다. AIME와 GPQA에는 결정론적 규칙 기반 판정자를 쓸 수 있지만, HLE는 답변의 절반 이상이 자유 서술형이라 불가능합니다.
이 숫자가 아닌 것
- vLLM이나 SGLang과의 비교가 아닙니다. 두 프로젝트 모두 자체 V4.1-Flash 최적화 글을 공개했지만 하드웨어와 워크로드가 다릅니다. 공개된 정면 비교는 없습니다.
- Ascend 950 데이터가 아닙니다. README는 Ascend 950 지원을 언급하지만, 차트는 SM100 전용입니다.
- 비용 모델이 아닙니다. tokens/s/GPU는 100만 토큰당 달러가 아닙니다. 비용에는 가동률, 전력, 감가상각, 네트워크, 스토리지, 장애 오버헤드가 들어갑니다.
- 실제 워크로드에 대한 보장이 아닙니다. 차트는 131,072 토큰 컨텍스트와 고정된 요청 패턴을 사용합니다. 여러분의 프롬프트 분포, 출력 길이, 캐시 적중률은 다를 것입니다.
- 독립 재현된 결과가 아닙니다. 2026-10-20 11:30 UTC 기준으로 제3자 재현 사례를 찾지 못했습니다.
재현하는 방법
저장소에는 스윕 하네스가 들어 있습니다.
# 디코드: DP 랭크당 요청 수를 스윕, nextn=3, 수용률 75%로 플롯
bash examples/sweep/run_sweep.sh decode ce-128k 131072 3 0.75

# 프리필: 배치 크기 스윕
bash examples/sweep/run_sweep.sh prefill pe-128k 131072

# 인코더: 이미지 크기 고정, 배치당 이미지 수 스윕
bash examples/sweep/run_sweep.sh encoder ve-800
스윕은 results.jsonl과 파레토 PNG를 sweeps/<tag>/ 아래에 씁니다. 멀티노드 실행에서는 dp_rank 0을 가진 노드만 JSONL을 쓰고, 나머지 노드는 작업을 마치면 종료됩니다. examples README는 프로파일러가 정상 상태 측정값을 흔든다고 경고하며, 그래서 스윕은 PROFILE=0으로 실행합니다.
평가 스크립트는 데이터셋을 문서에 적힌 경로에 두고 bash eval/aime/run.sh, bash eval/gpqa/run.sh, bash eval/hle/run.sh를 실행하면 됩니다. 스크립트가 데이터셋을 대신 내려받지는 않습니다.
프로덕션 주장
DeepSeek는 클러스터 하나가 하루 155조 토큰을 처리하며, 경부하 요금 기준으로 GPU 시간당 미화 38달러의 전체 매출을 낸다고 말합니다. 글에는 클러스터 규모, GPU 구성, 측정 기간이 공개되지 않았습니다. 매출은 이익이 아니며, 이 값으로 토큰당 비용을 도출할 수는 없습니다.
가장 잘못 인용되기 쉬운 숫자입니다. 벤치마크 결과가 아니라 프로덕션 규모에 대한 주장이며, 차트의 tokens/s/GPU와 비교할 수 없습니다. 단위 경제성이 필요하다면 클러스터 규모, 가동률, 에너지 비용, 상각을 물어야 합니다. 출시 글에는 하나도 없습니다.
다음에 필요한 것
- 정확한 커밋과 구성을 밝힌, SM100에서의 제3자 재현.
- 단일 노드 실행이라도 좋으니 Ascend 950의 처리량과 안정성 데이터.
- 같은 하드웨어, 컨텍스트, 워크로드에서 vLLM, SGLang과의 정면 비교.
- KV cache와 로드 밸런싱 계층까지 포함한 엔드투엔드 서빙 벤치마크. 릴리스가 빼놓은 부분입니다.
- 가동률과 에너지 단가를 명시한 100만 토큰당 비용.
그때까지 올바른 해석은 이렇습니다. 이 차트는 DeepSeek의 엔진이 지연 시간과 처리량을 그럴듯하게 맞바꿀 수 있음을 보여 줄 뿐, 여러분의 클러스터가 어떻게 동작할지는 말해 주지 않습니다.
다음: 추론 벤치마크를 읽는 더 자세한 가이드, 빠진 구성요소가 무엇을 뜻하는지, 또는 비교: DeepInfer vs vLLM, vs SGLang, vs TensorRT-LLM.