DeepInfer Benchmark:V4.1-Flash 的 Prefill 與 Decode
DeepInfer 的 V4.1-Flash 發佈數字,就是兩張 Pareto 圖加一組評測腳本。它們有用——前提是你在看標題之前,先看座標軸、假設,以及缺席的比較。
DeepInfer 是 DeepSeek 的開源推理框架,用來大規模服務 DeepSeek-V4.1-Flash。它公布的效能證據比發佈時的討論窄:單一硬件家族上的兩張 V4.1-Flash 圖,加上離線評測參考分數。目前還沒有第三方重現。
DeepInfer 支援 NVIDIA SM100 GPU 與華為 Ascend 950 NPU,但 DeepSeek 公布的效能圖只涵蓋 NVIDIA 硬件。讀這些數字時,這種不對稱是第一件要記住的事。
兩張圖
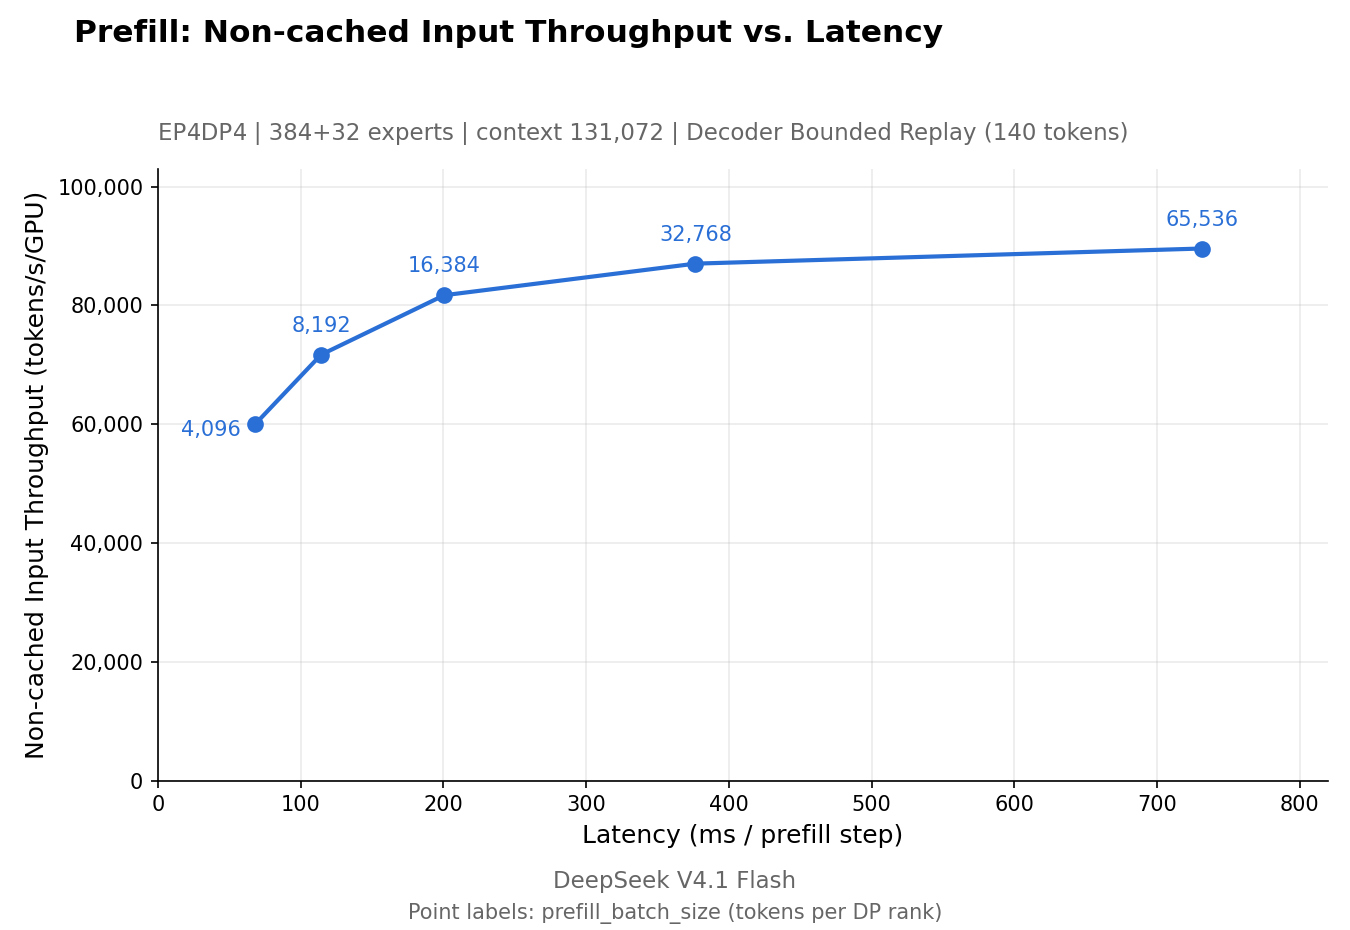
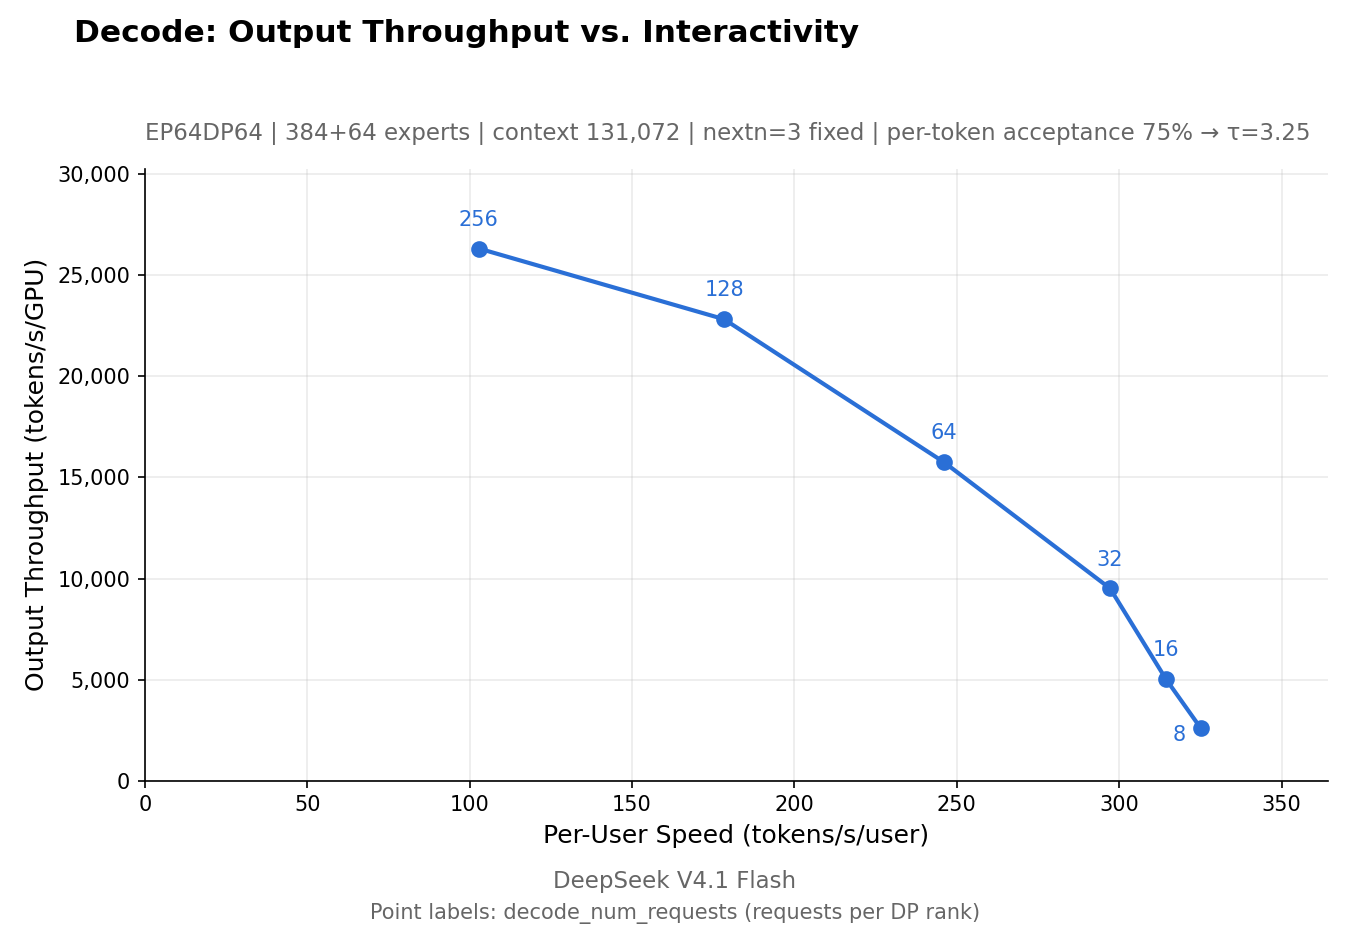
兩張圖都採 131,072 token 上下文。prefill 圖用 4 張 SM100 GPU,decode 圖用 64 張。每次執行都在同一個 scale-up 網域內。
座標軸代表什麼
| 圖表 | X 軸 | Y 軸 | 一個點代表什麼 |
|---|---|---|---|
| Prefill | 每個 prefill 步驟的延遲(ms) | 非快取輸入吞吐量(tokens/s/GPU) | 一個批次大小;批次越大,吞吐量與延遲一起上升。 |
| Decode | 單一使用者速度(tokens/s/user) | 輸出吞吐量(tokens/s/GPU) | 每個 DP rank 的請求數;併發請求越多,吞吐量越高,但每個使用者越慢。 |
兩張圖都沒有畫出端到端請求延遲。prefill 延遲是每步延遲,不是真實請求的 time-to-first-token。decode 的單一使用者速度是穩態的彙總數字,不是單次 API 呼叫的延遲。網絡、排隊、分詞與服務層都在量測範圍之外。
約略讀值
圖上沒有印出吞吐量數值;標籤是批次大小或請求數。下表的數字是從座標軸讀出並四捨五入的。它們有助於理解曲線形狀,不適合採購決策。
| 圖表 | 資料點 | 吞吐量 | 延遲 / 單一使用者速度 |
|---|---|---|---|
| Prefill | 4,096 批次 | ~60k tokens/s/GPU | ~68 ms/step |
| Prefill | 16,384 批次 | ~81k tokens/s/GPU | ~200 ms/step |
| Prefill | 65,536 批次 | ~89k tokens/s/GPU | ~730 ms/step |
| Decode | 8 個請求/rank | ~2.6k tokens/s/GPU | ~325 tokens/s/user |
| Decode | 64 個請求/rank | ~15.5k tokens/s/GPU | ~248 tokens/s/user |
| Decode | 256 個請求/rank | ~26k tokens/s/GPU | ~103 tokens/s/user |
評測數字
儲存庫也附上三個 benchmark 的離線評測腳本。這些是模型在預設配置下的參考分數,不是引擎之間的比較。
| Benchmark | 題數 | 樣本數 | Pass@1 |
|---|---|---|---|
| AIME 2026 | 30 | 每題 32 個樣本 | 99.9% |
| GPQA Diamond | 198 | 每題 8 個樣本 | 93.4% |
| HLE-Full | 2,500(2,158 文字 + 342 圖片) | 1 | 42.6% |
這些是參考數字,不是保證。eval README 說,重複執行可能因取樣而有小幅差異。它也提到,Pass@1 只有在 coverage_complete 為 true 時才有效(見 summary.json)——對任何要重現數字的人來說,這是很實用的細節。
評測流程把生成與評分分開,因此你可以用不同的 judge 重新評分既有輸出。預設 judge 是 LLM 服務;AIME 與 GPQA 有確定性的規則式 judge,HLE 則沒有,因為它超過一半的答案是自由格式。
這些數字不是什麼
- 不是與 vLLM 或 SGLang 的比較。 兩個項目都有自己的 V4.1-Flash 優化文章,硬件與工作負載不同。沒有公開的正面對決。
- 不是 Ascend 950 的數據。 README 說支援 Ascend 950,但圖表只有 SM100。
- 不是成本模型。 tokens/s/GPU 不等於每百萬 token 的美元成本。成本還需要利用率、電力、折舊、網絡、儲存與故障開銷。
- 不是真實工作負載的保證。 圖表使用固定的 131,072 token 上下文與固定請求模式。你的 prompt 分佈、輸出長度與快取命中率都會不同。
- 未經獨立重現。 截至 2026-10-20 11:30 UTC,我們找不到第三方複現。
如何重現
儲存庫提供掃描工具:
# Decode:掃描每個 DP rank 的請求數,nextn=3,以 75% 接受率繪圖
bash examples/sweep/run_sweep.sh decode ce-128k 131072 3 0.75

# Prefill:掃描批次大小
bash examples/sweep/run_sweep.sh prefill pe-128k 131072

# Encoder:固定圖片尺寸,掃描每個批次的圖片數
bash examples/sweep/run_sweep.sh encoder ve-800
掃描會把 results.jsonl 與 Pareto PNG 寫到 sweeps/<tag>/。多節點執行時,只有持有 dp_rank 0 的節點會寫 JSONL;其他節點完成後就結束。examples README 提醒 profiler 會干擾穩態讀值,因此掃描以 PROFILE=0 執行。
至於評測腳本,請把資料集放在文件指定的路徑,然後執行 bash eval/aime/run.sh、bash eval/gpqa/run.sh 或 bash eval/hle/run.sh。腳本不會幫你下載資料集。
生產環境的說法
DeepSeek 說單一叢集每天服務 155 兆 token,在谷時電價下整體營收為每 GPU 小時 US$38。該文沒有披露叢集規模、GPU 組成或量測時間窗。營收不是利潤,這個數字也無法用來推算每 token 成本。
這是最容易被引錯的數字。它是生產規模的宣稱,不是 benchmark 結果,也不能與圖上的 tokens/s/GPU 相比。若你需要單位經濟,請要求叢集規模、利用率、電力成本與攤提——這些都不在發佈文章中。
我們希望接下來看到什麼
- 在 SM100 上的第三方重現,附上確切 commit 與配置。
- Ascend 950 的吞吐量與穩定性數據,即使是單節點執行。
- 在相同硬件、上下文與工作負載下,與 vLLM、SGLang 的正面對決。
- 端到端服務 benchmark,包含 KV cache 與負載平衡層——也就是本次發佈略去的部分。
- 在明確的利用率與電價假設下,每百萬 token 的成本。
在那之前,正確的讀法是:這些圖顯示 DeepSeek 的引擎能以合理的方式用延遲換吞吐量;它們沒有告訴你你的叢集會跑出什麼。
接著讀:更深入的推理 benchmark 閱讀指南、缺這些元件意味著什麼,或比較:DeepInfer vs vLLM、vs SGLang、vs TensorRT-LLM。